Publicado 9 de septiembre de 2026
El 53 % del tráfico web en 2025 no era una persona
Imperva midió todas las peticiones que pasaron por su red y descubrió que el tráfico automatizado superó al humano por segundo año consecutivo: 53 % máquinas, 47 % personas. Qué cuenta como bot, por qué tu analítica casi con seguridad no lo muestra y qué implica que la mayoría de los lectores de tus fichas de producto sean software.
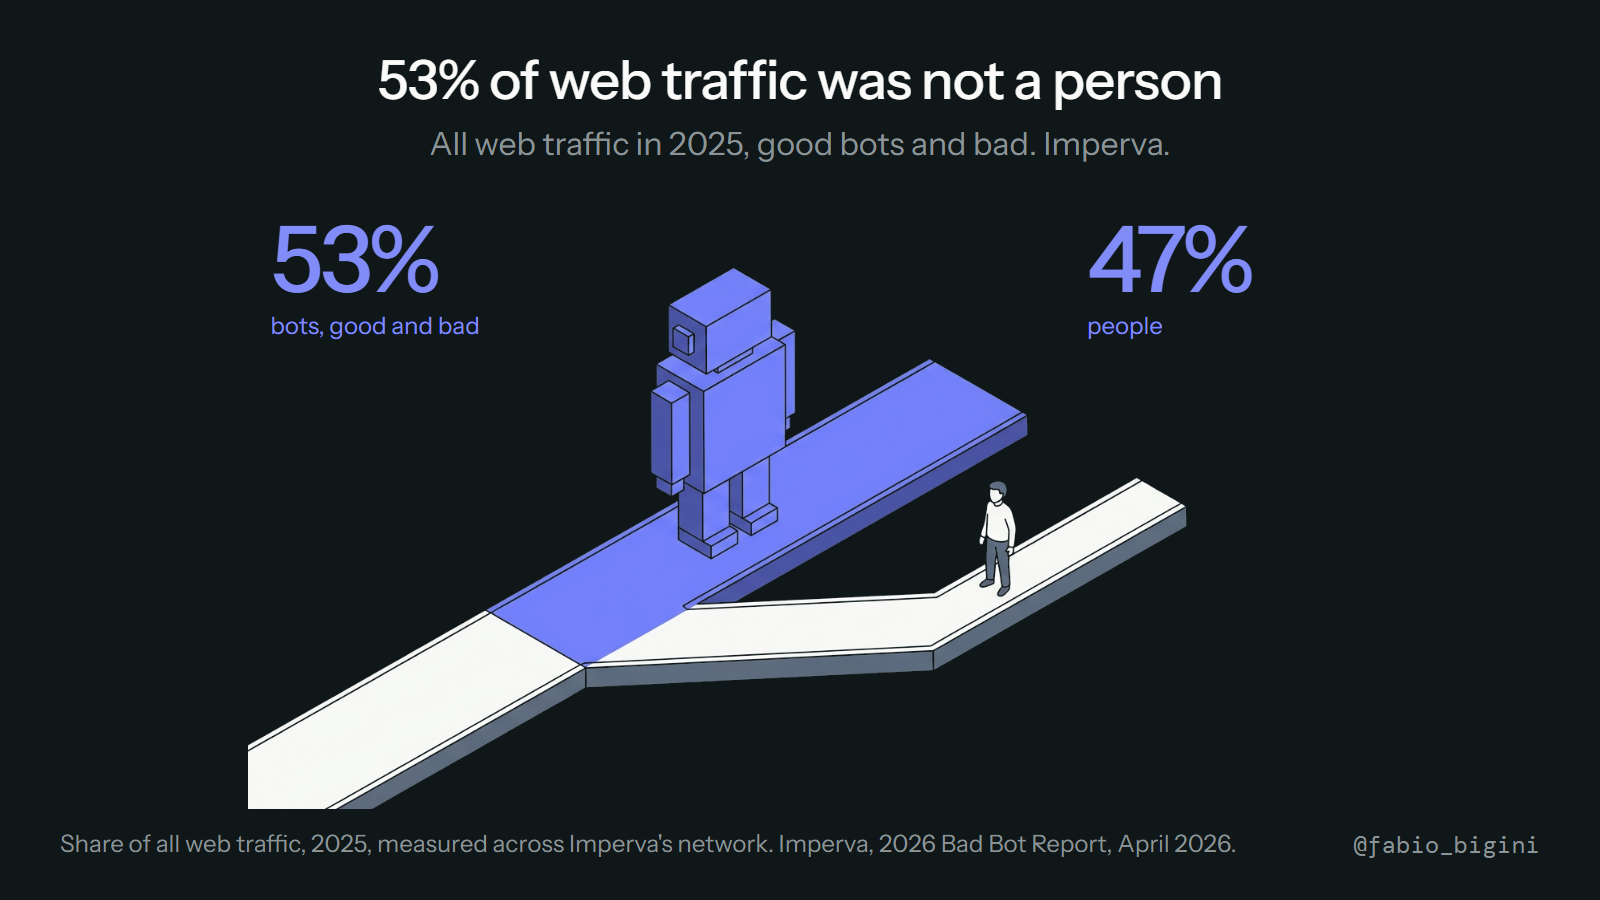
Imperva, empresa del grupo Thales, publica un recuento anual de lo que realmente pasa por su red. La edición de 2026, referida a 2025, indica que «el tráfico automatizado sigue superando la actividad humana en internet y representa más del 53 % de todo el tráfico web en 2025, frente al 51 % del año anterior», mientras que «la actividad humana ha bajado a solo el 47 % y sigue cayendo». (Imperva, 2026 Bad Bot Report: Bad Bots in the Agentic Age, abril de 2026)
Es el segundo año consecutivo en que las máquinas superan a las personas en la web abierta. Conviene precisar qué dice y qué no dice esa cifra, porque lo útil para quien gestiona un sitio no es el titular.
Qué cuenta como bot
«Bot» en este recuento significa cualquier petición automatizada, no solo las maliciosas. Abarca al menos cuatro poblaciones distintas, y cada una visita por motivos diferentes.
Los rastreadores de buscadores indexan tus páginas para que la gente las encuentre. Los rastreadores de IA descargan páginas para responder preguntas o entrenar modelos, por eso una tienda que nunca ha recibido una visita procedente de una IA puede estar siendo rastreada cientos de veces al mes. Los scrapers copian precios, niveles de stock y contenidos para competidores, agregadores y revendedores. Y un grupo más reciente, los agentes, navega en nombre de una persona que ha hecho una pregunta, haciendo clic y leyendo en tiempo real.
El enfoque que Imperva da a esta edición es precisamente la llegada de ese último grupo: el informe se subtitula «Bad Bots in the Agentic Age». La compañía no publica en el resumen público un reparto limpio entre bots buenos y bots malos, así que la afirmación honesta es la de la tarjeta: el 53 % del tráfico fue automatizado, de todo tipo, y el 47 % fue humano.
Por qué tu analítica no muestra esto
Abre Google Analytics en una tienda normal y no verás nada parecido a una cuota del 53 % de máquinas. No es una contradicción, es una diferencia de medición, y entenderla importa.
Las herramientas de analítica que se ejecutan en el navegador solo cuentan visitantes que ejecutan JavaScript. La mayoría de los rastreadores no lo hacen. Piden el HTML, lo leen y se van, así que nunca disparan el script de seguimiento y nunca aparecen en tus informes. Además, las plataformas de analítica filtran a propósito los bots conocidos por su user agent, porque los informes existen para describir clientes.
Imperva cuenta en una capa distinta. Se sitúa delante del sitio como servicio de red y ve todas las peticiones, con script o sin él. Así que las dos cifras miden cosas diferentes: tu analítica mide personas que renderizaron una página, Imperva mide peticiones que llegaron. Ambas son correctas.
La consecuencia práctica es que el único sitio donde puedes ver ese tráfico son los logs de tu servidor o el panel de tu CDN. Si nunca has mirado ahí, nunca has visto la mayor parte de lo que lee tu sitio.
Qué implica que la mayoría de los lectores sean máquinas
Para una tienda o una empresa de servicios, se derivan tres cosas.
Tu ficha de producto tiene dos públicos con necesidades distintas. Una persona ojea una foto, un precio y una puntuación de reseñas. Un rastreador lee el texto y los datos estructurados, y la foto le da igual. Una página que a un humano le parece completa puede estar casi vacía para una máquina si las especificaciones están dentro de una imagen, el precio lo pinta un script después de cargar o las condiciones de entrega están en un PDF. Los dos públicos son ya grandes, y solo uno de ellos puede preguntarte algo.
La lectura por máquinas es lo que alimenta las respuestas de IA. Cuando alguien pregunta a un asistente de IA dónde comprar un producto, el asistente responde a partir de páginas que se descargaron y se leyeron, ya sea por su propio rastreador o en directo durante la búsqueda. Estar ausente de esa descarga es el motivo más habitual por el que una empresa no aparece en la respuesta, y es invisible en analítica porque la visita nunca se registró ahí.
Parte del tráfico trabaja en tu contra. El informe existe porque buena parte de esa automatización es hostil: scrapers que se llevan precios para bajarlos, credential stuffing, acaparamiento de stock. Bloquear de forma indiscriminada es la respuesta equivocada, porque los rastreadores que alimentan las búsquedas y las respuestas de IA se parecen mucho, a nivel de red, a los que se llevan tus precios. La decisión está en qué agentes dejar entrar, no en si poner o no una puerta.
Qué revisar
Tres comprobaciones, cada una de media hora o menos.
Mira los logs de tu servidor o de tu CDN de una semana y cuenta las peticiones por user agent. Busca los rastreadores de IA conocidos, si recibieron un 200 o un 403 y qué páginas pidieron. Un número sorprendente de sitios los bloquea por accidente con un ajuste de seguridad que nadie recuerda haber activado.
Abre la ficha de tu producto más vendido con JavaScript desactivado, o descárgala con una petición HTTP simple. Lo que sobreviva es más o menos lo que ve un rastreador. Si falta el precio y las especificaciones clave, ahí tienes tu problema.
Después comprueba si tu robots.txt dice lo que crees que dice. Es el único archivo que decide cuál de estas poblaciones tiene permiso para leerte, y suele escribirse una vez y no volver a leerse nunca.
La pregunta de la tarjeta era: ¿cuándo fue la última vez que tu analítica mostró más personas que bots, y lo sabrías? Para casi cualquier sitio, la respuesta honesta es que la analítica no podía decírtelo en ningún sentido.