Gepubliceerd 9 september 2026
53% van het webverkeer in 2025 was geen mens
Imperva meet elk verzoek dat zijn netwerk passeert en zag geautomatiseerd verkeer voor het tweede jaar op rij het menselijke verkeer voorbijstreven: 53% machines, 47% mensen. Wat als bot geldt, waarom je analytics dit vrijwel zeker niet laat zien, en wat het betekent als de meeste lezers van je productpagina's software zijn.
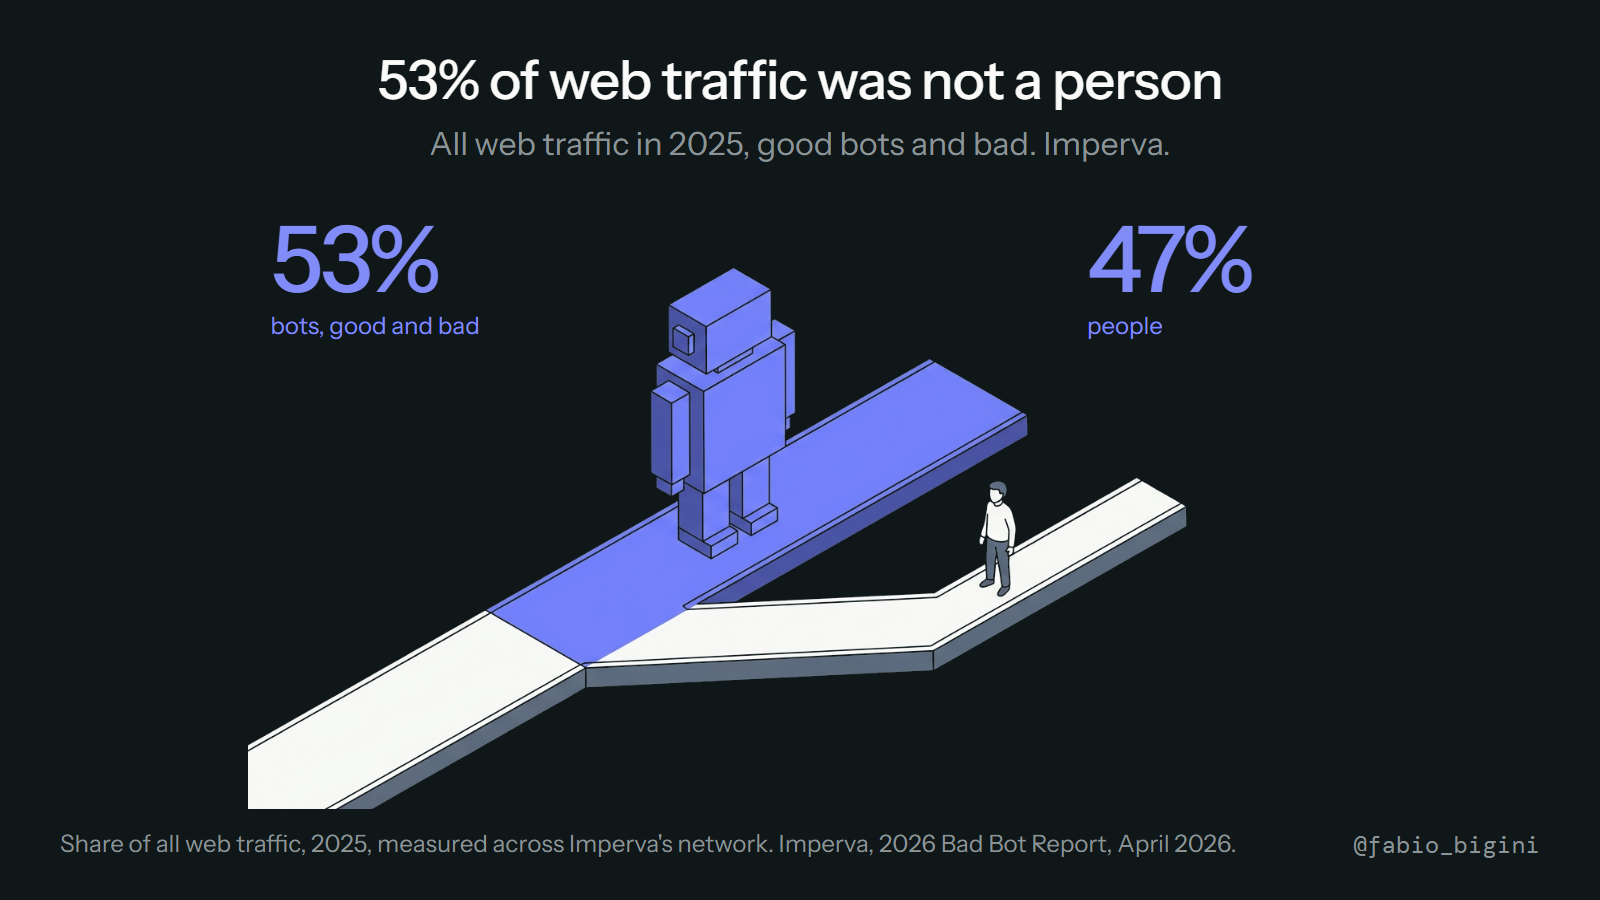
Imperva, een bedrijf van Thales, publiceert jaarlijks een telling van wat er werkelijk over zijn netwerk gaat. De editie van 2026, over het jaar 2025, meldt dat "automated traffic continues to outpace human activity online, accounting for more than 53% of all web traffic in 2025, up from 51% the year before", terwijl "human activity has declined to just 47% and continues to fall". (Imperva, 2026 Bad Bot Report: Bad Bots in the Agentic Age, april 2026)
Dat is het tweede jaar op rij waarin machines op het open web in de meerderheid waren. Het is de moeite waard om precies te zijn over wat dat cijfer wel en niet zegt, want het bruikbare deel voor een site-eigenaar zit niet in de kop.
Wat als bot geldt
"Bot" betekent in deze telling elk geautomatiseerd verzoek, niet alleen een kwaadaardig verzoek. Het gaat om minstens vier verschillende groepen, en die komen om verschillende redenen langs.
Zoekcrawlers indexeren je pagina's zodat mensen ze kunnen vinden. AI-crawlers halen pagina's op om vragen te beantwoorden of om modellen te trainen, en daarom kan een winkel die nog nooit een bezoeker via AI heeft gezien toch honderden keren per maand gecrawld worden. Scrapers kopiëren prijzen, voorraadstanden en content voor concurrenten, vergelijkingssites en wederverkopers. En een nieuwere groep, agents, browst namens iemand die een vraag heeft gesteld en klikt en leest in realtime.
Imperva zet die laatste groep centraal in deze editie: de ondertitel van het rapport is "Bad Bots in the Agentic Age". Het bedrijf publiceert in de openbare samenvatting geen duidelijke splitsing tussen goede en slechte bots, dus de eerlijke conclusie is die op de kaart: 53% van het verkeer was geautomatiseerd, van elke soort, en 47% was menselijk.
Waarom je analytics dit niet laat zien
Open Google Analytics van een gewone webshop en je ziet niets dat op een machineaandeel van 53% lijkt. Dat is geen tegenspraak, het is een verschil in meting, en het is belangrijk om dat te begrijpen.
Analyticstools die in de browser draaien tellen alleen bezoekers die JavaScript uitvoeren. De meeste crawlers doen dat niet. Ze vragen de HTML op, lezen die en gaan weer weg, dus ze activeren het trackingscript nooit en komen nooit in je rapporten voor. Analyticsplatforms filteren bekende bots ook bewust weg op basis van de user agent, omdat de rapporten bedoeld zijn om klanten te beschrijven.
Imperva meet op een andere laag. Het staat als netwerkdienst vóór de site en ziet elk verzoek, met of zonder script. De twee cijfers meten dus verschillende dingen: jouw analytics meet mensen die een pagina hebben gerenderd, Imperva meet verzoeken die zijn binnengekomen. Beide zijn juist.
Het praktische gevolg is dat je dit verkeer alleen kunt zien in je serverlogs of in het dashboard van je CDN. Als je daar nooit hebt gekeken, heb je het grootste deel van wat je site leest nooit gezien.
Wat het betekent als de meeste lezers machines zijn
Voor een webshop of een dienstverlener volgen daar drie dingen uit.
Je productpagina heeft twee doelgroepen met verschillende behoeften. Een mens scant een foto, een prijs en een reviewscore. Een crawler leest de tekst en de structured data en negeert de foto volledig. Een pagina die voor een mens compleet lijkt, kan voor een machine bijna leeg zijn als de specificaties in een afbeelding staan, de prijs na het laden door een script wordt getekend, of de leveringsvoorwaarden in een pdf zitten. Beide doelgroepen zijn nu groot, en maar één ervan kan je een vraag stellen.
Machinaal lezen is wat AI-antwoorden voedt. Als iemand een AI-assistent vraagt waar een product te koop is, komt het antwoord uit pagina's die zijn opgehaald en gelezen, door de eigen crawler of live tijdens het zoeken. Ontbreken bij dat ophalen is de meest voorkomende reden dat een bedrijf niet in het antwoord voorkomt, en het is onzichtbaar in analytics omdat het bezoek daar nooit is opgedoken.
Een deel van het verkeer werkt tegen je. Dit rapport bestaat juist omdat een groot deel van die automatisering vijandig is: scrapers die prijzen ophalen om eronder te gaan zitten, credential stuffing, het leegtrekken van voorraad. Zonder onderscheid blokkeren is het verkeerde antwoord, want de crawlers die zoekresultaten en AI-antwoorden voeden lijken op netwerkniveau sterk op de crawlers die je prijzen meenemen. De afweging is welke agents je binnenlaat, niet of je een poort hebt.
Wat je kunt controleren
Drie checks, elk een half uur of minder.
Bekijk je server- of CDN-logs over een week en tel de verzoeken per user agent. Je zoekt de bij naam bekende AI-crawlers, of ze een 200 of een 403 kregen, en welke pagina's ze opvroegen. Een verrassend aantal sites blokkeert ze per ongeluk via een beveiligingsinstelling die niemand zich herinnert te hebben aangezet.
Open je best verkopende productpagina met JavaScript uitgeschakeld, of haal hem op met een gewoon HTTP-verzoek. Wat er overblijft, is ongeveer wat een crawler ziet. Als de prijs en de belangrijkste specificaties ontbreken, dan is dat je gat.
Controleer daarna of je robots.txt zegt wat je denkt dat hij zegt. Het is het enige bestand dat bepaalt welke van deze groepen je überhaupt mogen lezen, en meestal wordt het één keer geschreven en nooit meer bekeken.
De vraag op de kaart was: wanneer liet je analytics voor het laatst meer mensen dan bots zien, en zou je het weten? Voor bijna elke site is het eerlijke antwoord dat analytics je dat hoe dan ook niet kon vertellen.