Publié 9 septembre 2026
Nous avons posé les mêmes 20 questions deux fois. Les 20 ont donné une réponse différente
Même modèle, mêmes questions, à une minute d'intervalle. Chaque paire a renvoyé une liste d'entreprises différente, et 13 fois sur 20 l'entreprise citée en premier a changé. Pourquoi les réponses des IA bougent entre deux exécutions identiques, ce que cela implique pour qui veut vérifier comment l'IA le décrit, et pourquoi une capture d'écran n'est pas une mesure.
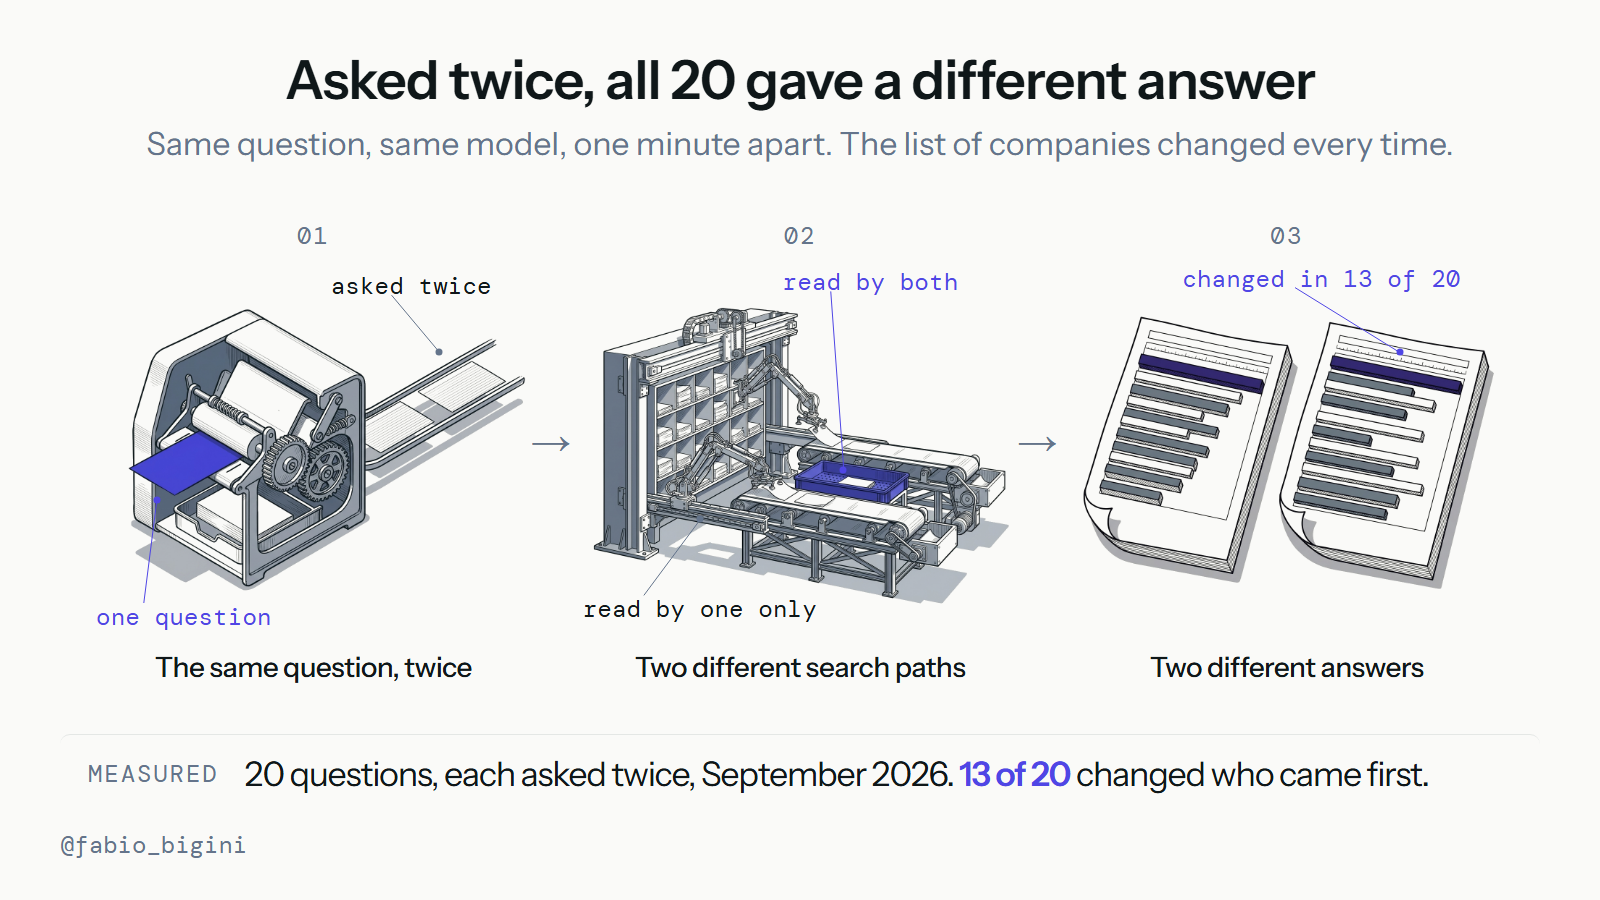
La semaine dernière, nous avons réalisé un audit pour une entreprise européenne de services de laboratoire : vingt questions qu'un acheteur poserait avant de choisir un fournisseur, adressées à un assistant IA avec recherche web, pour voir si l'entreprise apparaissait dans les réponses. Pour tester la méthode, nous avons posé chaque question deux fois, à environ une minute d'intervalle, le même jour, sans rien changer.
Les vingt paires ont renvoyé des réponses différentes. Pas légèrement réordonnées : différentes. Chaque paire citait un ensemble d'entreprises distinct. Dans treize cas sur vingt, l'entreprise citée en premier a changé. La paire médiane différait de quatre à cinq entreprises, et le recouvrement entre les deux listes était de 0,40, c'est-à-dire que moins de la moitié des noms étaient communs aux deux exécutions. Les pages consultées par le modèle différaient elles aussi dans les vingt paires, avec un écart médian de sept domaines.
Ce sont nos propres chiffres, issus de notre propre audit, calculés à partir des exécutions brutes. L'entreprise n'est pas nommée ici.
Pourquoi la même question donne des réponses différentes
Le premier réflexe est de croire que le modèle manque de cohérence. Ce n'est pas vraiment ce qui se passe.
Quand vous posez à un assistant IA une question à laquelle il ne peut pas répondre de mémoire, il ne répond pas directement. Il rédige une ou plusieurs requêtes de recherche, les envoie à un moteur de recherche, récupère une liste de résultats, en ouvre certains et rédige une réponse à partir de ce qu'il a lu. La formulation des requêtes qu'il invente peut varier d'une exécution à l'autre. Les résultats de recherche eux-mêmes changent d'une minute à l'autre. Le choix des résultats que le modèle décide d'ouvrir varie. Et c'est seulement ensuite que l'échantillonnage propre au modèle ajoute encore de la variation.
La réponse est donc la dernière étape d'une chaîne dont presque tous les maillons antérieurs sont instables. Dans nos exécutions, les domaines consultés différaient dans chaque paire, et c'est là le mécanisme : deux listes de lecture différentes produisent deux réponses différentes. Le modèle n'était pas d'humeur changeante, il lisait des pages différentes.
C'est aussi pourquoi la variation n'est pas répartie uniformément. Une question dont la réponse est claire et bien indexée a tendance à rester stable. Une question comme « quels fournisseurs devrais-je envisager en Europe », où des dizaines d'entreprises pourraient légitimement apparaître et où aucune page ne fait autorité, est précisément le type de question où l'étape de recherche a de la marge pour partir dans tous les sens. Et ce sont ces questions qui ont le plus bougé dans nos données.
Ce que cela implique si vous vérifiez votre propre visibilité
La plupart des gens vérifient comme on s'y attend : ils ouvrent ChatGPT, demandent si leur entreprise est citée, obtiennent une réponse et se forment une opinion. Nos données indiquent que cette opinion, prise isolément, ne vaut à peu près rien.
Si une exécution unique a environ une chance sur deux de vous citer, alors poser la question une seule fois ne vous apprend presque rien. Posez-la lors d'une bonne exécution et vous concluez que tout va bien. Posez-la lors d'une mauvaise et vous concluez que vous êtes invisible. Les deux conclusions découlent de la même réalité, et les deux sont fausses, parce que la vraie réponse est une probabilité, pas un oui ou un non.
L'erreur inverse est tout aussi vraie. Une entreprise qui apparaît sur une capture d'écran n'a pas « gagné » la réponse, et un concurrent qui apparaît une fois ne la domine pas. Sans répétition, impossible de distinguer une position stable d'un coup de chance.
Ce que nous faisons face à cela
Trois choses, et aucune n'est ingénieuse : c'est simplement la discipline qu'impose la variance.
Répéter chaque question. Une exécution unique est une anecdote. Nous posons chaque question plusieurs fois et traitons le résultat comme un taux, pas comme un fait : cité dans six exécutions sur dix, et non « cité ».
Publier la dispersion, pas un chiffre unique. Un indicateur de visibilité sans taille d'échantillon derrière lui, c'est une capture d'écran avec un pourcentage dessus. Le résultat utile, c'est la fréquence à laquelle vous apparaissez, sur combien d'exécutions, quel jour, avec les questions écrites noir sur blanc pour que le contrôle puisse être refait.
Regarder ce qui a été consulté, pas seulement ce qui a été dit. Comme la variation vient de l'étape de recherche, la liste de lecture est plus instructive que la réponse. Si votre page ne figure jamais parmi les pages ouvertes, aucune répétition ne changera le résultat, et c'est un problème que l'on peut corriger. Si votre page est ouverte mais que vous n'êtes toujours pas cité, c'est un autre problème, avec une autre solution.
Les limites honnêtes de tout ceci
Il s'agit de vingt questions, une entreprise, un modèle avec recherche web, un jour, depuis un seul pays. C'est suffisant pour montrer que des exécutions identiques donnent des résultats différents, ce qui était l'objectif, mais pas pour dire de combien elles diffèrent en général, ni si d'autres assistants varient plus ou moins. Nous n'avons fait des paires répétées que sur l'un des trois assistants de cet audit.
Un résultat publié connexe mérite d'être connu : quand Orbit Media a suivi 13 184 citations sur quatre outils d'IA, les quatre ne citaient le même domaine pour la même question que 1,7 % du temps. (Orbit Media, LLM Citation Study) Des outils différents lisent des pages presque entièrement différentes. Notre résultat montre qu'un même outil fait de même, d'une minute à l'autre.
La question reste posée : si la liste bouge à chaque fois, que signifie un classement ? Il signifie un taux, mesuré sur des exécutions répétées, ou il ne signifie rien.