Publicado 9 de septiembre de 2026
Hicimos las mismas 20 preguntas dos veces. Las 20 dieron una respuesta distinta
Mismo modelo, mismas preguntas, con un minuto de diferencia. Cada pareja devolvió una lista de empresas distinta y en 13 de 20 cambió la empresa mencionada en primer lugar. Por qué las respuestas de la IA se mueven entre ejecuciones idénticas, qué implica para quien quiera comprobar cómo le describe la IA y por qué una captura de pantalla no es una medición.
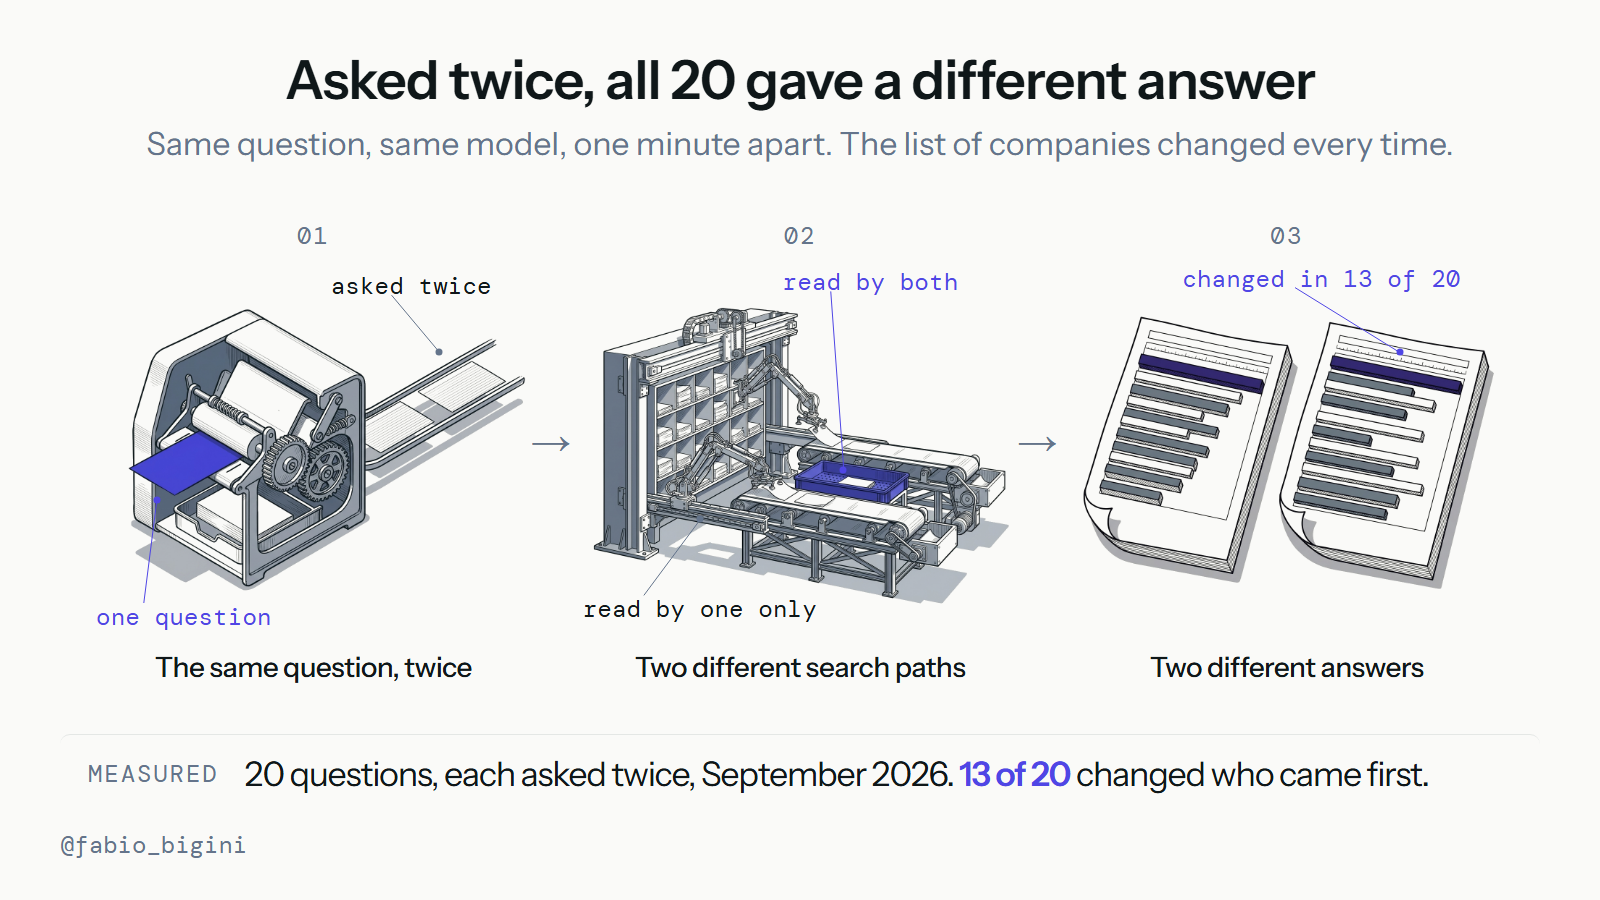
La semana pasada hicimos una auditoría para una empresa europea de servicios de laboratorio: veinte preguntas que un comprador haría antes de elegir proveedor, planteadas a un asistente de IA con búsqueda web, para ver si la empresa aparecía en las respuestas. Para comprobar el método, hicimos cada pregunta dos veces, con un minuto de diferencia, el mismo día y sin cambiar nada.
Las veinte parejas salieron distintas. No con un ligero cambio de orden, distintas: cada pareja mencionaba un conjunto de empresas diferente. En trece de las veinte cambió la empresa mencionada en primer lugar. La pareja mediana se diferenciaba en cuatro o cinco empresas, y el solapamiento entre las dos listas fue de 0,40, es decir, menos de la mitad de los nombres coincidían en ambas ejecuciones. Las páginas que recuperó el modelo también fueron distintas en las veinte parejas, con una mediana de siete dominios de diferencia.
Son nuestros propios datos, de nuestra propia auditoría, calculados a partir de las ejecuciones en bruto. No damos aquí el nombre de la empresa.
Por qué la misma pregunta da respuestas distintas
Lo primero que se piensa es que el modelo es incoherente. En realidad no es eso lo que pasa.
Cuando le haces a un asistente de IA una pregunta que no puede responder de memoria, no responde directamente. Escribe una o varias consultas de búsqueda, las envía a un buscador, recibe una lista de resultados, abre algunos y redacta una respuesta con lo que ha leído. La formulación de las consultas que inventa puede variar entre ejecuciones. Los propios resultados de búsqueda cambian de un minuto a otro. Cuáles de esos resultados decide abrir el modelo también varía. Y solo entonces el muestreo del propio modelo añade variación por encima de todo eso.
Así que la respuesta es el último paso de una cadena en la que casi todos los pasos anteriores son inestables. En nuestras ejecuciones los dominios recuperados fueron distintos en todas y cada una de las parejas, y ahí está el mecanismo: dos listas de lectura distintas producen dos respuestas distintas. El modelo no estaba de mal humor, estaba leyendo páginas diferentes.
Por eso mismo la variación no se reparte de forma uniforme. Una pregunta con una respuesta clara y bien indexada tiende a ser estable. Una pregunta del tipo "qué proveedores debería considerar en Europa", donde podrían aparecer razonablemente decenas de empresas y ninguna página es la referencia, es justo el caso en el que el paso de recuperación tiene margen para irse por otro lado, y esas fueron las preguntas que más se movieron en nuestros datos.
Qué implica esto si estás comprobando tu propia visibilidad
Casi todo el mundo lo comprueba como cabría esperar: abre ChatGPT, pregunta si su empresa aparece, obtiene una respuesta y se forma una opinión. Nuestros datos dicen que esa opinión, por sí sola, no vale casi nada.
Si una sola ejecución tiene más o menos las mismas probabilidades de mencionarte que de no hacerlo, preguntar una vez no te dice casi nada. Preguntas en una ejecución buena y concluyes que vas bien. Preguntas en una mala y concluyes que eres invisible. Las dos conclusiones salen de la misma realidad de fondo y las dos están mal, porque la respuesta real es una probabilidad, no un sí o un no.
Lo mismo vale para el error contrario. Una empresa que aparece en una captura de pantalla no ha "ganado" la respuesta, y un competidor que aparece una vez no la domina. Sin repetición no hay forma de distinguir una posición estable de una casualidad.
Qué hacemos nosotros
Tres cosas, y ninguna es brillante, son simplemente la disciplina que exige la varianza.
Repetir cada pregunta. Una sola ejecución es una anécdota. Hacemos cada pregunta varias veces y tratamos el resultado como una tasa, no como un hecho: mencionado en seis de diez ejecuciones, no "mencionado".
Informar de la dispersión, no de un número. Una cifra de visibilidad sin tamaño de muestra detrás es una captura de pantalla con un porcentaje encima. El resultado útil es con qué frecuencia apareces, sobre cuántas ejecuciones, en qué día y con las preguntas por escrito para que la comprobación se pueda repetir.
Mirar qué se recuperó, no solo qué se dijo. Como la variación viene del paso de recuperación, la lista de lectura es más informativa que la respuesta. Si tu página nunca está entre las que se abren, repetir la prueba no cambiará el resultado, y ese es un problema que se puede arreglar. Si tu página se abre y aun así no te mencionan, es un problema distinto con una solución distinta.
Los límites honestos de esto
Son veinte preguntas, una empresa, un modelo con búsqueda web, un día y un país. Basta para demostrar que ejecuciones idénticas dan resultados distintos, que era el objetivo, y no basta para decir cuánto difieren en general ni si otros asistentes varían más o menos. Solo hicimos parejas repetidas en uno de los tres asistentes de esa auditoría.
Hay un resultado publicado relacionado que conviene conocer: cuando Orbit Media analizó 13.184 citas en cuatro herramientas de IA, las cuatro coincidieron en citar el mismo dominio para la misma pregunta solo el 1,7 % de las veces. (Orbit Media, LLM Citation Study) Herramientas distintas leen páginas casi totalmente distintas. Nuestro resultado dice que la misma herramienta también lo hace, de un minuto al siguiente.
La pregunta sigue en pie: si la lista cambia cada vez, ¿qué significa un ranking? Significa una tasa, medida sobre ejecuciones repetidas, o no significa nada.