Gepubliceerd 9 september 2026
We stelden dezelfde 20 vragen twee keer. Alle 20 gaven een ander antwoord
Zelfde model, zelfde vragen, één minuut ertussen. Elk paar leverde een andere lijst bedrijven op, en bij 13 van de 20 veranderde welk bedrijf als eerste werd genoemd. Waarom AI-antwoorden verschuiven tussen identieke runs, wat dat betekent voor iedereen die controleert hoe AI hem beschrijft, en waarom één screenshot geen meting is.
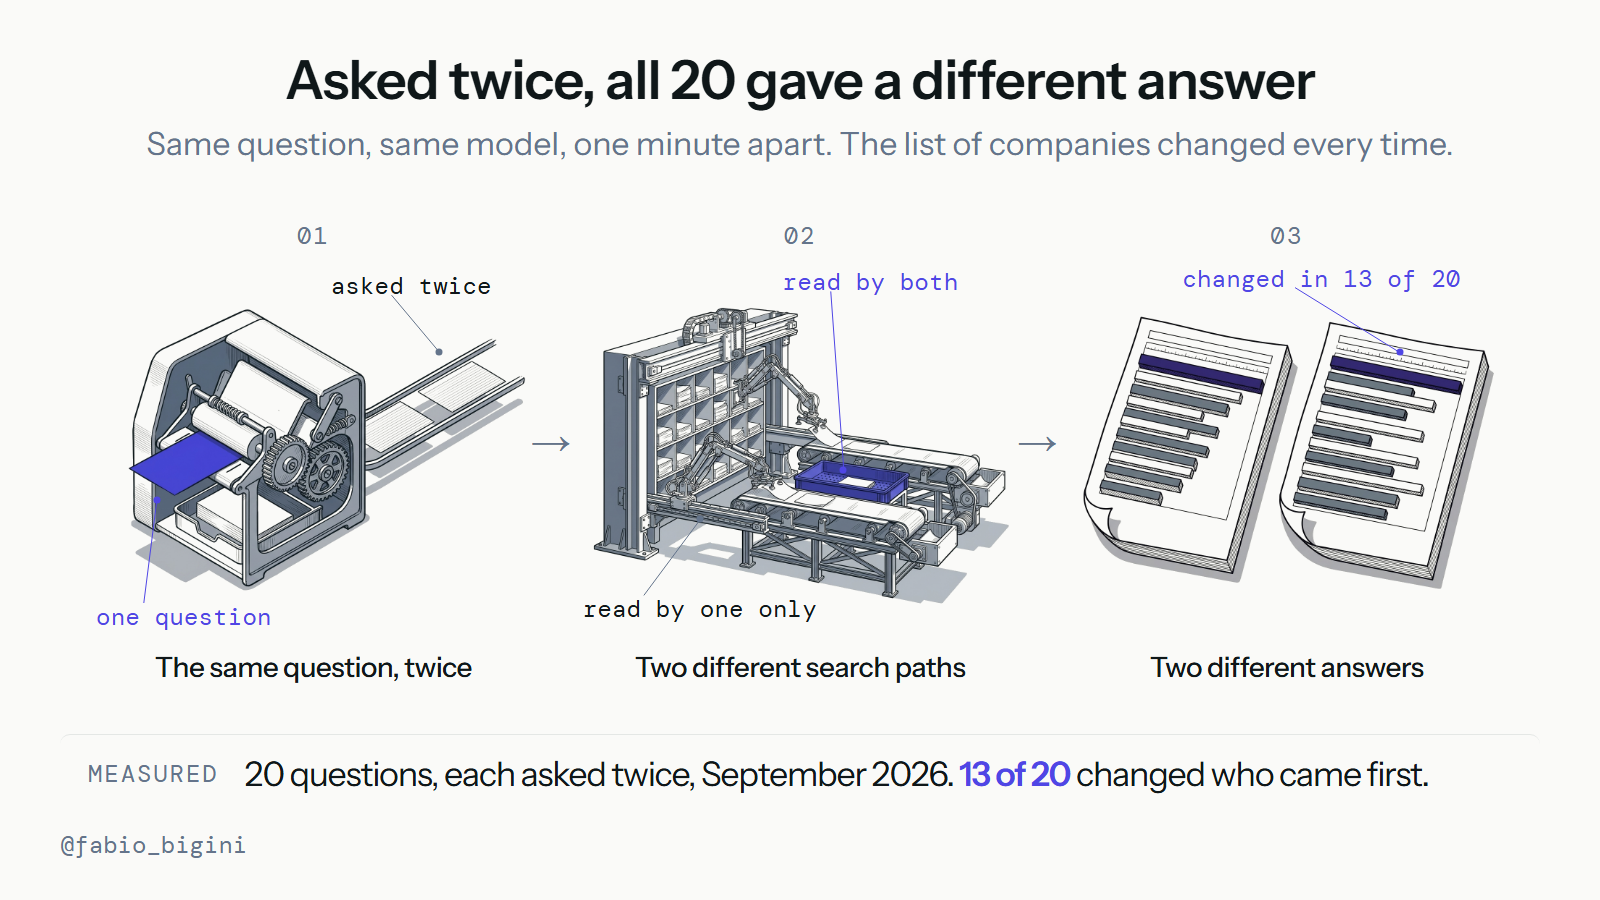
Vorige week deden we een audit voor een Europees bedrijf in laboratoriumdiensten: twintig vragen die een inkoper stelt voordat hij een leverancier kiest, voorgelegd aan een AI-assistent met websearch, om te zien of het bedrijf in de antwoorden voorkwam. Om de methode te controleren stelden we elke vraag twee keer, ongeveer een minuut na elkaar, op dezelfde dag, zonder iets te veranderen.
Alle twintig paren kwamen anders terug. Niet licht van volgorde veranderd, maar anders: elk paar noemde een andere set bedrijven. In dertien van de twintig veranderde welk bedrijf als eerste werd genoemd. Het mediane paar verschilde vier tot vijf bedrijven, en de overlap tussen de twee lijsten was 0,40, wat betekent dat minder dan de helft van de namen in beide runs voorkwam. Ook de pagina's die het model ophaalde verschilden in alle twintig paren, met een mediaan van zeven domeinen.
Dat zijn onze eigen cijfers, uit onze eigen audit, berekend op basis van de ruwe runs. Het bedrijf noemen we hier niet.
Waarom dezelfde vraag andere antwoorden oplevert
De eerste reflex is te denken dat het model inconsistent is. Dat is niet echt wat er gebeurt.
Als je een AI-assistent een vraag stelt die hij niet uit zijn geheugen kan beantwoorden, antwoordt hij niet direct. Hij schrijft een of meer zoekopdrachten, stuurt die naar een zoekmachine, krijgt een lijst met resultaten terug, opent er een paar en schrijft een antwoord op basis van wat hij heeft gelezen. De formulering van de zoekopdrachten die hij verzint kan per run verschillen. De zoekresultaten zelf veranderen van minuut tot minuut. Welke van die resultaten het model opent, varieert. En pas daarna voegt de sampling van het model zelf er nog variatie aan toe.
Het antwoord is dus de laatste stap in een keten waarin bijna elke eerdere stap instabiel is. In onze runs verschilden de opgehaalde domeinen in elk paar, en dat is het mechanisme: twee verschillende leeslijsten leveren twee verschillende antwoorden op. Het model was niet humeurig, het las andere pagina's.
Dit is ook waarom de variatie niet gelijkmatig verdeeld is. Een vraag met een duidelijk, goed geïndexeerd antwoord is meestal stabiel. Een vraag als "welke leveranciers moet ik in Europa overwegen", waar tientallen bedrijven redelijkerwijs kunnen opduiken en geen enkele pagina gezaghebbend is, is precies het type waarbij de zoekstap ruimte heeft om af te dwalen. En dat waren de vragen die in onze data het meest bewogen.
Wat dit betekent als je je eigen zichtbaarheid controleert
De meeste mensen controleren zoals je zou verwachten: ze openen ChatGPT, vragen of hun bedrijf genoemd wordt, krijgen een antwoord en vormen een beeld. Onze data zegt dat dat beeld op zichzelf nagenoeg waardeloos is.
Als één run ongeveer evenveel kans heeft om je wel als niet te noemen, dan zegt één keer vragen je bijna niets. Vraag het op een goede run en je concludeert dat het prima gaat. Vraag het op een slechte run en je concludeert dat je onzichtbaar bent. Beide conclusies komen uit dezelfde onderliggende werkelijkheid, en beide zijn fout, want het echte antwoord is een kans, geen ja of nee.
Hetzelfde geldt voor de omgekeerde fout. Een bedrijf dat in één screenshot voorkomt heeft het antwoord niet "gewonnen", en een concurrent die één keer verschijnt domineert het niet. Zonder herhaling is er geen manier om een stabiele positie van een gelukstreffer te onderscheiden.
Wat wij eraan doen
Drie dingen, en geen ervan is slim, het is gewoon de discipline die de variantie afdwingt.
Herhaal elke vraag. Eén run is een anekdote. Wij stellen elke vraag meerdere keren en behandelen het resultaat als een percentage, niet als een feit: genoemd in zes van de tien runs, niet "genoemd".
Rapporteer de spreiding, niet één getal. Een zichtbaarheidscijfer zonder steekproefomvang erachter is een screenshot met een percentage erop. De bruikbare uitkomst is hoe vaak je verschijnt, uit hoeveel runs, op welke dag, met de vragen erbij genoteerd zodat de controle herhaald kan worden.
Kijk naar wat er is opgehaald, niet alleen naar wat er is gezegd. Omdat de variatie uit de zoekstap komt, is de leeslijst informatiever dan het antwoord. Als jouw pagina nooit bij de geopende pagina's zit, verandert geen enkele herhaling de uitkomst, en dat is een oplosbaar probleem. Als jouw pagina wel geopend wordt maar je nog steeds niet genoemd wordt, is dat een ander probleem met een andere oplossing.
De eerlijke grenzen hiervan
Dit zijn twintig vragen, één bedrijf, één model met websearch, één dag, vanuit één land. Genoeg om te laten zien dat identieke runs van elkaar verschillen, en dat was het punt. Niet genoeg om te zeggen hoeveel ze in het algemeen verschillen, of dat andere assistenten meer of minder variëren. We hebben herhaalparen maar bij één van de drie assistenten in die audit gedraaid.
Er is een gepubliceerde bevinding die hierbij hoort: toen Orbit Media 13.184 citaties over vier AI-tools volgde, waren die vier het bij dezelfde vraag slechts 1,7% van de tijd eens over het citeren van hetzelfde domein. (Orbit Media, LLM Citation Study) Verschillende tools lezen bijna volledig andere pagina's. Onze uitkomst zegt dat dezelfde tool dat ook doet, van de ene minuut op de andere.
De vraag blijft staan: als de lijst elke keer verschuift, wat betekent een ranking dan? Het betekent een percentage, gemeten over herhaalde runs, of het betekent niets.