Publicado 9 de setembro de 2026
Fizemos as mesmas 20 perguntas duas vezes. Todas as 20 deram uma resposta diferente
O mesmo modelo, as mesmas perguntas, com um minuto de intervalo. Todos os pares devolveram uma lista de empresas diferente e, em 13 dos 20 casos, mudou a empresa nomeada em primeiro lugar. Por que razão as respostas de IA mudam entre execuções idênticas, o que isso significa para quem quer saber como a IA o descreve e por que motivo uma captura de ecrã não é uma medição.
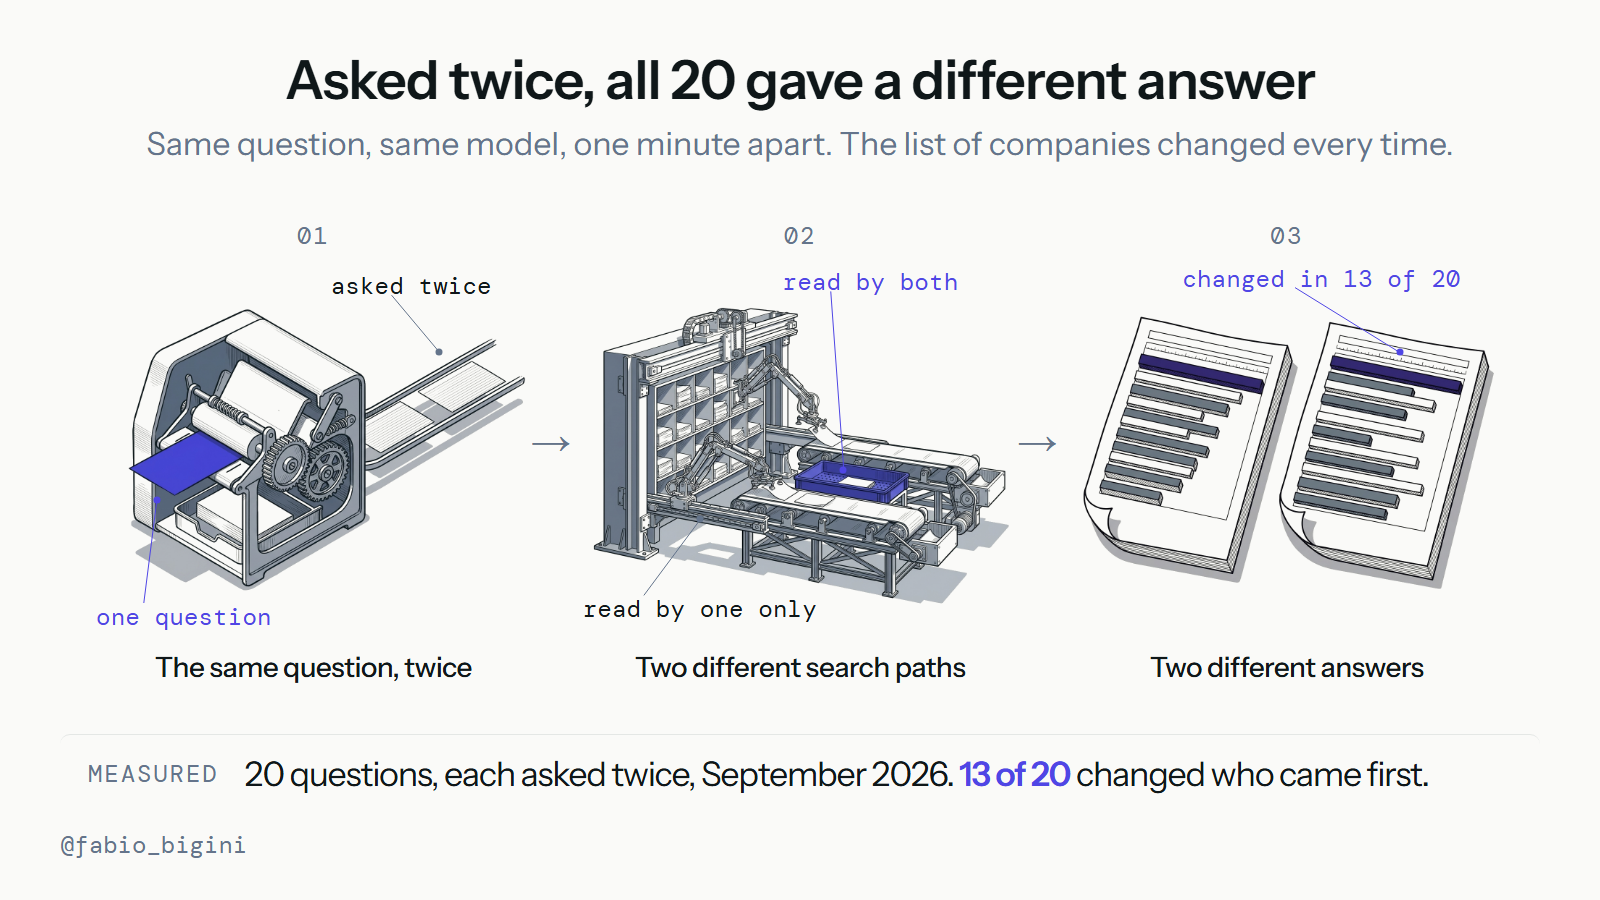
Na semana passada fizemos uma auditoria a uma empresa europeia de serviços de laboratório: vinte perguntas que um comprador faria antes de escolher um fornecedor, colocadas a um assistente de IA com pesquisa web, para ver se a empresa aparecia nas respostas. Para testar o método, fizemos cada pergunta duas vezes, com cerca de um minuto de intervalo, no mesmo dia, sem alterar nada.
Os vinte pares devolveram resultados diferentes. Não ligeiramente reordenados, diferentes: cada par nomeou um conjunto distinto de empresas. Em treze dos vinte, mudou a empresa nomeada em primeiro lugar. O par mediano divergia em quatro ou cinco empresas e a sobreposição entre as duas listas foi de 0,40, ou seja, menos de metade dos nomes era comum às duas execuções. As páginas que o modelo consultou também diferiram nos vinte pares, com uma mediana de sete domínios.
Estes são os nossos números, da nossa auditoria, calculados a partir das execuções em bruto. A empresa não é aqui identificada.
Por que razão a mesma pergunta dá respostas diferentes
O instinto é assumir que o modelo é inconsistente. Não é bem isso que acontece.
Quando se faz a um assistente de IA uma pergunta a que ele não consegue responder de memória, ele não responde diretamente. Escreve uma ou mais consultas de pesquisa, envia-as para um motor de busca, recebe uma lista de resultados, abre alguns deles e escreve uma resposta a partir do que leu. A formulação das consultas que inventa pode variar entre execuções. Os próprios resultados de pesquisa mudam de minuto para minuto. Quais desses resultados o modelo decide abrir também varia. E só depois é que a amostragem do próprio modelo acrescenta mais variação.
Portanto, a resposta é o último passo de uma cadeia em que quase todos os passos anteriores são instáveis. Nas nossas execuções, os domínios consultados diferiram em todos os pares, e é aí que está o mecanismo: duas listas de leitura diferentes produzem duas respostas diferentes. O modelo não estava com mudanças de humor, estava a ler páginas diferentes.
É também por isso que a variação não se distribui de forma uniforme. Uma pergunta com uma resposta clara e bem indexada tende a ser estável. Uma pergunta como "que fornecedores devo considerar na Europa", em que dezenas de empresas podem razoavelmente aparecer e nenhuma página é autoritativa, é exatamente o tipo de caso em que o passo de recuperação tem espaço para divagar. E foram essas as perguntas que mais oscilaram nos nossos dados.
O que isto significa se está a avaliar a sua própria visibilidade
A maioria das pessoas faz a verificação da forma esperada: abre o ChatGPT, pergunta se a sua empresa aparece, recebe uma resposta e forma uma opinião. Os nossos dados dizem que essa opinião, por si só, vale quase nada.
Se uma única execução tem uma probabilidade mais ou menos de metade de o nomear, fazer a pergunta uma vez não diz praticamente nada. Se acertar numa boa execução, conclui que está tudo bem. Se acertar numa má, conclui que é invisível. As duas conclusões vêm da mesma realidade e ambas estão erradas, porque a resposta real é uma probabilidade, não um sim ou não.
O mesmo vale para o erro inverso. Uma empresa que aparece numa captura de ecrã não "ganhou" a resposta, e um concorrente que aparece uma vez não a está a dominar. Sem repetição não há forma de distinguir uma posição estável de uma posição de sorte.
O que fazemos quanto a isso
Três coisas, e nenhuma delas é inteligente, são apenas a disciplina que a variância exige.
Repetir todas as perguntas. Uma execução única é uma anedota. Fazemos cada pergunta várias vezes e tratamos o resultado como uma taxa, não como um facto: nomeado em seis de dez execuções, e não "nomeado".
Reportar a dispersão, não um número. Um valor de visibilidade sem dimensão de amostra por trás é uma captura de ecrã com uma percentagem em cima. O resultado útil é a frequência com que aparece, em quantas execuções, em que dia, com as perguntas registadas para que a verificação possa ser repetida.
Olhar para o que foi consultado, não apenas para o que foi dito. Como a variação vem do passo de recuperação, a lista de leitura é mais informativa do que a resposta. Se a sua página nunca está entre as páginas abertas, repetir a execução não muda nada, e esse é um problema com solução. Se a sua página é aberta e continua a não ser nomeado, é outro problema, com outra solução.
Os limites honestos disto
São vinte perguntas, uma empresa, um modelo com pesquisa web, um dia, um país. É suficiente para mostrar que execuções idênticas dão resultados diferentes, que era o objetivo, e não é suficiente para dizer quanto diferem em geral, nem se outros assistentes variam mais ou menos. Só fizemos pares repetidos num dos três assistentes dessa auditoria.
Há um resultado publicado relacionado que vale a pena conhecer: quando a Orbit Media analisou 13 184 citações em quatro ferramentas de IA, as quatro só citaram o mesmo domínio para a mesma pergunta em 1,7% dos casos. (Orbit Media, LLM Citation Study) Ferramentas diferentes leem páginas quase totalmente diferentes. O nosso resultado diz que a mesma ferramenta também o faz, de um minuto para o outro.
A pergunta continua de pé: se a lista muda de cada vez, o que significa uma classificação? Significa uma taxa, medida em execuções repetidas, ou não significa nada.