Veröffentlicht 9. September 2026
Wir haben dieselben 20 Fragen zweimal gestellt. Alle 20 kamen mit einer anderen Antwort zurück
Gleiches Modell, gleiche Fragen, eine Minute Abstand. Jedes Paar nannte eine andere Liste von Unternehmen, und in 13 von 20 Fällen änderte sich, wer zuerst genannt wurde. Warum KI-Antworten zwischen identischen Durchläufen schwanken, was das für alle bedeutet, die prüfen wollen, wie KI über sie spricht, und warum ein einzelner Screenshot keine Messung ist.
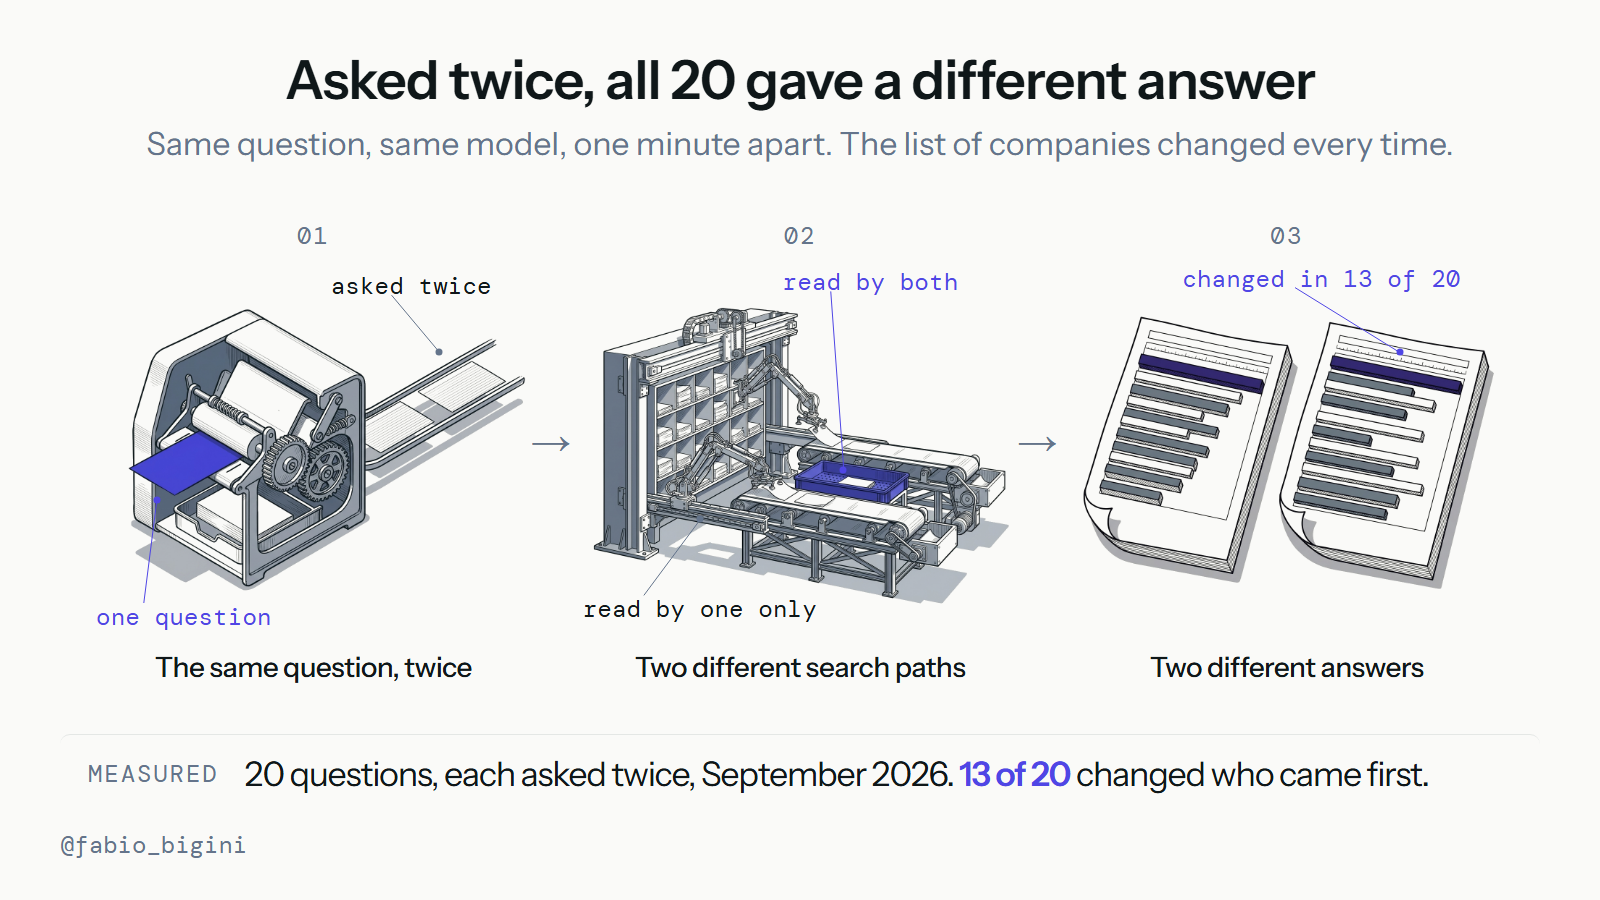
Vergangene Woche haben wir ein Audit für einen europäischen Anbieter von Labordienstleistungen durchgeführt: zwanzig Fragen, die ein Einkäufer vor der Wahl eines Lieferanten stellt, gerichtet an einen KI-Assistenten mit Websuche, um zu sehen, ob das Unternehmen in den Antworten auftaucht. Zur Kontrolle der Methode haben wir jede Frage zweimal gestellt, im Abstand von etwa einer Minute, am selben Tag, ohne irgendetwas zu ändern.
Alle zwanzig Paare fielen unterschiedlich aus. Nicht leicht umsortiert, sondern unterschiedlich: Jedes Paar nannte eine andere Gruppe von Unternehmen. In dreizehn von zwanzig Fällen änderte sich, welches Unternehmen zuerst genannt wurde. Im Median unterschieden sich die Paare um vier bis fünf Unternehmen, und die Überschneidung zwischen den beiden Listen lag bei 0,40. Weniger als die Hälfte der Namen kam also in beiden Durchläufen vor. Auch die Seiten, die das Modell abrief, unterschieden sich in allen zwanzig Paaren, im Median um sieben Domains.
Das sind unsere eigenen Zahlen, aus unserem eigenen Audit, berechnet aus den Rohdaten der Durchläufe. Das Unternehmen wird hier nicht genannt.
Warum dieselbe Frage unterschiedliche Antworten liefert
Der erste Impuls ist die Annahme, das Modell sei inkonsistent. Das trifft es nicht.
Wenn Sie einem KI-Assistenten eine Frage stellen, die er nicht aus dem Gedächtnis beantworten kann, antwortet er nicht direkt. Er formuliert eine oder mehrere Suchanfragen, schickt sie an eine Suchmaschine, bekommt eine Trefferliste zurück, öffnet einige davon und schreibt aus dem Gelesenen eine Antwort. Die Formulierung der Suchanfragen, die er sich ausdenkt, kann von Durchlauf zu Durchlauf variieren. Die Suchergebnisse selbst ändern sich von Minute zu Minute. Welche dieser Ergebnisse das Modell öffnet, variiert ebenfalls. Und erst danach kommt die Variation durch das eigene Sampling des Modells obendrauf.
Die Antwort ist also der letzte Schritt in einer Kette, in der fast jeder vorherige Schritt instabil ist. In unseren Durchläufen unterschieden sich die abgerufenen Domains in jedem einzelnen Paar, und genau das ist der Mechanismus: Zwei unterschiedliche Leselisten ergeben zwei unterschiedliche Antworten. Das Modell war nicht launisch, es hat andere Seiten gelesen.
Deshalb verteilt sich die Schwankung auch nicht gleichmäßig. Eine Frage mit einer klaren, gut indexierten Antwort ist tendenziell stabil. Eine Frage wie "welche Lieferanten sollte ich in Europa in Betracht ziehen", bei der Dutzende Unternehmen plausibel auftauchen könnten und keine Seite maßgeblich ist, ist genau der Fall, in dem der Rechercheschritt Spielraum zum Abschweifen hat. Das waren in unseren Daten auch die Fragen mit der größten Bewegung.
Was das bedeutet, wenn Sie Ihre eigene Sichtbarkeit prüfen
Die meisten prüfen so, wie man es erwarten würde: ChatGPT öffnen, fragen, ob das eigene Unternehmen vorkommt, eine Antwort bekommen, sich ein Urteil bilden. Unsere Daten sagen: Dieses Urteil ist für sich genommen nahezu wertlos.
Wenn ein einzelner Durchlauf mit ungefähr gleicher Wahrscheinlichkeit Ihren Namen nennt oder nicht, dann sagt einmaliges Fragen fast nichts aus. Fragen Sie an einem guten Durchlauf, halten Sie alles für in Ordnung. Fragen Sie an einem schlechten, halten Sie sich für unsichtbar. Beide Schlüsse stammen aus derselben Realität, und beide sind falsch, denn die echte Antwort ist eine Wahrscheinlichkeit, kein Ja oder Nein.
Dasselbe gilt für den umgekehrten Fehler. Ein Unternehmen, das in einem Screenshot auftaucht, hat die Antwort nicht "gewonnen", und ein Wettbewerber, der einmal erscheint, dominiert sie nicht. Ohne Wiederholung lässt sich eine stabile Position nicht von einer glücklichen unterscheiden.
Was wir dagegen tun
Drei Dinge, und keines davon ist raffiniert. Es ist schlicht die Disziplin, die die Streuung verlangt.
Jede Frage wiederholen. Ein einzelner Durchlauf ist eine Anekdote. Wir stellen jede Frage mehrfach und behandeln das Ergebnis als Quote, nicht als Fakt: in sechs von zehn Durchläufen genannt, nicht "genannt".
Die Streuung berichten, nicht eine Zahl. Ein Sichtbarkeitswert ohne Stichprobengröße dahinter ist ein Screenshot mit einer Prozentzahl drauf. Brauchbar ist die Angabe, wie oft Sie auftauchen, bei wie vielen Durchläufen, an welchem Tag, mit den notierten Fragen, damit die Prüfung wiederholbar ist.
Anschauen, was abgerufen wurde, nicht nur, was gesagt wurde. Weil die Schwankung aus dem Rechercheschritt kommt, ist die Leseliste aussagekräftiger als die Antwort. Wenn Ihre Seite nie unter den geöffneten Seiten ist, ändert auch beliebig häufiges Wiederholen nichts am Ergebnis, und das ist ein lösbares Problem. Wenn Ihre Seite geöffnet wird und Sie trotzdem nicht genannt werden, ist das ein anderes Problem mit einer anderen Lösung.
Die ehrlichen Grenzen des Ganzen
Das sind zwanzig Fragen, ein Unternehmen, ein Modell mit Websuche, ein Tag, aus einem Land. Es reicht, um zu zeigen, dass identische Durchläufe voneinander abweichen, und darum ging es. Es reicht nicht, um zu sagen, wie stark sie generell abweichen oder ob andere Assistenten mehr oder weniger schwanken. Wir haben Wiederholungspaare nur bei einem der drei Assistenten in diesem Audit gefahren.
Es gibt einen verwandten veröffentlichten Befund, den man kennen sollte: Als Orbit Media 13.184 Zitationen über vier KI-Tools hinweg auswertete, zitierten alle vier nur in 1,7 % der Fälle dieselbe Domain zur selben Frage. (Orbit Media, LLM Citation Study) Unterschiedliche Tools lesen fast durchgängig unterschiedliche Seiten. Unser Ergebnis sagt: Dasselbe Tool tut das auch, von einer Minute zur nächsten.
Die Frage bleibt bestehen: Wenn sich die Liste jedes Mal ändert, was bedeutet dann ein Ranking? Es bedeutet eine Quote, gemessen über wiederholte Durchläufe, oder es bedeutet nichts.