Publié 7 septembre 2026
Comment un site web décide quels crawlers d'IA peuvent entrer
Avant qu'un assistant IA puisse lire une page, quatre contrôles s'enchaînent en quelques centaines de millisecondes : réputation de l'IP, en-têtes de la requête, test JavaScript, limite de débit. N'importe lequel peut la refouler, et 22,6 % des 10 000 premiers sites bloquent volontairement au moins un crawler d'IA. Ce que fait chaque contrôle, pourquoi une boutique peut être invisible sans le savoir, et comment le vérifier.
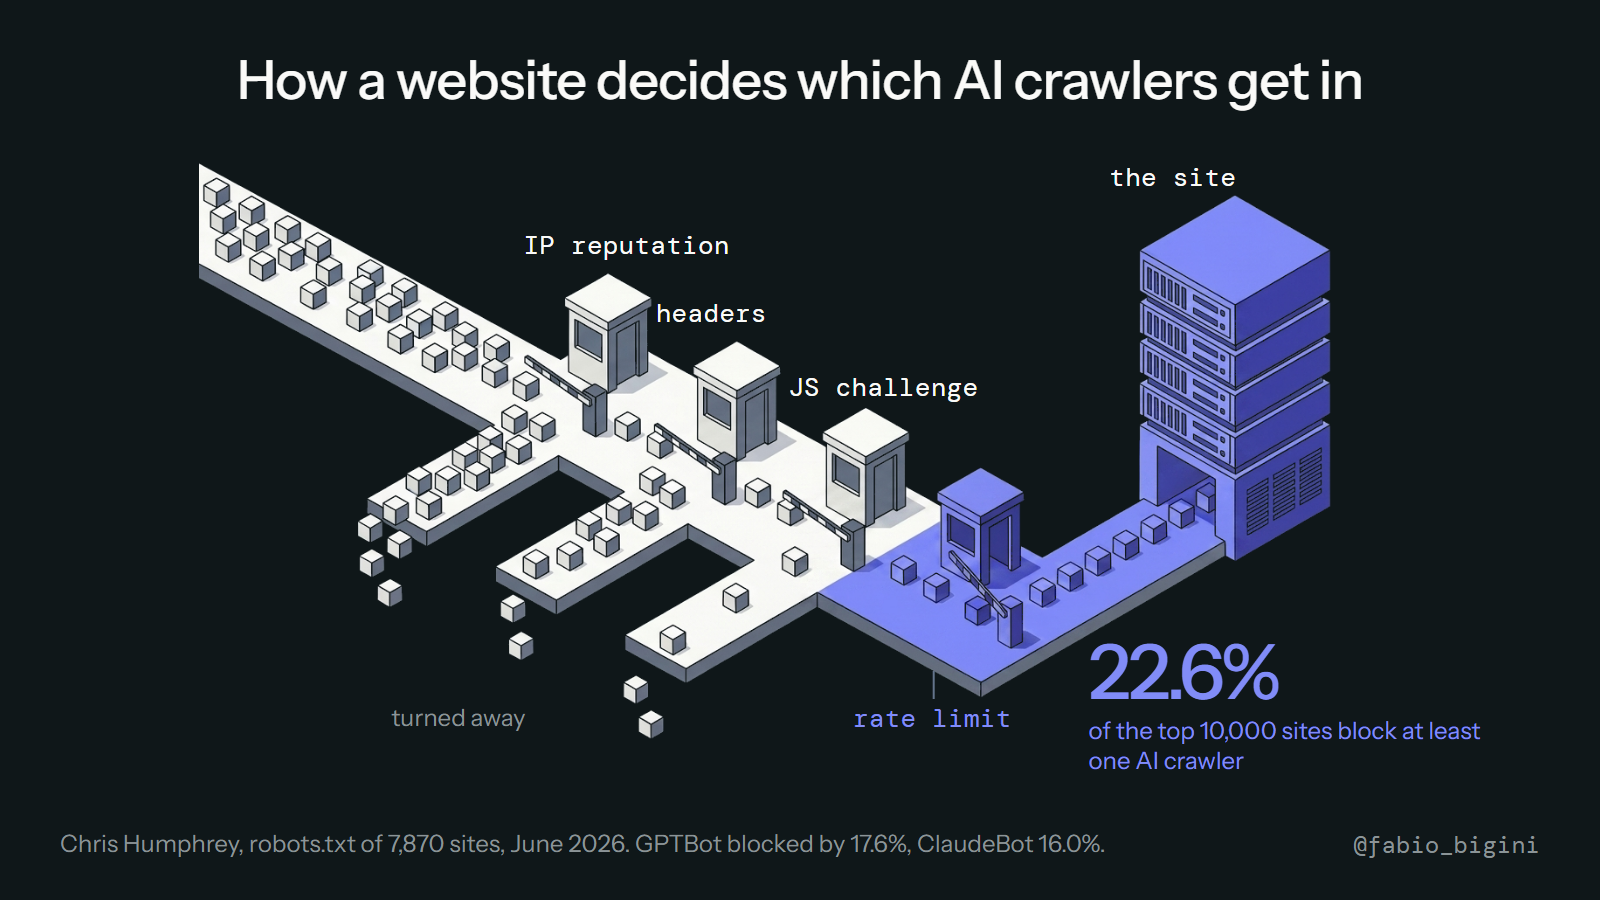
Quand un assistant IA lit votre page produit, il n'ouvre pas un navigateur pour la regarder. Il envoie une requête, comme n'importe quel crawler, et votre infrastructure d'hébergement décide en quelques centaines de millisecondes si elle répond. La plupart des commerçants n'ont jamais vu cette décision, et un nombre croissant de sites la tranchent contre les crawlers d'IA sans que personne dans l'entreprise le sache.
Voici les quatre contrôles, dans l'ordre où une requête les rencontre, et ce que disent les chiffres.
Les quatre portes
1. Réputation de l'IP. Avant que votre serveur ne voie quoi que ce soit, un CDN ou une couche de gestion des bots (Cloudflare, Akamai, DataDome et compagnie) regarde d'où vient la requête. Les plages d'IP de crawlers connus reçoivent une étiquette. Certaines sont autorisées, d'autres soumises à un test, d'autres purement rejetées. Cette porte fonctionne selon les règles du fournisseur réseau, souvent celles par défaut.
2. En-têtes de la requête. Chaque crawler se présente avec une chaîne user-agent : GPTBot, ClaudeBot, PerplexityBot, Google-Extended. Votre fichier robots.txt, et toute règle basée sur les en-têtes, dit oui ou non nom par nom. C'est la seule porte que vous contrôlez entièrement avec un fichier texte, et celle que mesure l'étude ci-dessous.
3. Test JavaScript. En cas de doute, la couche de sécurité renvoie un petit script que le visiteur doit exécuter avant le chargement de la vraie page. Les navigateurs le font sans que ça se voie. La plupart des robots d'IA n'exécutent pas JavaScript : le test devient un mur, l'assistant reçoit la page de vérification et non votre page produit, puis passe à autre chose.
4. Limite de débit. Même un crawler autorisé qui demande trop de pages trop vite se fait ralentir ou couper. Pour un crawler qui lit cinq pages afin de répondre à une question, cela compte rarement ; pour un crawler d'entraînement qui aspire tout un catalogue, oui. Et les hébergeurs fixent souvent une seule limite pour les deux.
Une seule porte suffit pour dire non. L'assistant ne signale pas le refus : la réponse se construit simplement à partir des pages qu'il a pu lire.
Ce que disent les chiffres
Chris Humphrey a analysé le robots.txt des 10 000 premiers sites web (7 870 avec un résultat exploitable) en juin 2026 (source) :
| Part des grands sites qui le bloquent | |
|---|---|
| GPTBot (OpenAI) | 17,6 % |
| ClaudeBot (Anthropic) | 16,0 % |
| Google-Extended | 14,5 % |
| PerplexityBot | 10,4 % |
| Au moins un crawler d'IA | 22,6 % |
Il s'agit uniquement de la deuxième porte. Les portes une, trois et quatre ne sont pas visibles de l'extérieur et sont, d'après notre expérience avec les boutiques, plus souvent la raison pour laquelle une page reste illisible : une règle anti-bot par défaut au niveau du CDN, ou un test JavaScript que personne ne se souvient avoir activé.
Pourquoi on se trompe facilement
Bloquer les crawlers d'entraînement est un choix défendable : un éditeur peut refuser que ses textes servent à entraîner des modèles. Mais le même blocage attrape souvent le crawler qui lit les pages pour répondre à une question immédiatement. OpenAI, par exemple, utilise des noms différents pour l'entraînement (GPTBot) et pour la recherche en direct (OAI-SearchBot, ChatGPT-User) ; une règle écrite contre « GPT » attrape les trois. Résultat : une boutique qui a refusé l'entraînement et qui, sans le vouloir, a refusé les recommandations.
Les plateformes d'hébergement commettent la même erreur à votre place. Plusieurs hébergeurs e-commerce managés livrent leurs offres avec les crawlers d'IA bloqués par défaut à la porte une ou trois, et le réglage dort dans un panneau de sécurité que personne n'ouvre.
Comment le vérifier en cinq minutes
- Ouvrez
votreboutique.com/robots.txtet cherchezGPTBot,ClaudeBot,PerplexityBot,OAI-SearchBot. UnDisallow: /sous l'un d'eux, c'est la deuxième porte qui dit non. - Récupérez une page produit avec le user-agent d'un crawler, depuis l'extérieur de votre réseau (un
curlavec-A "GPTBot"suffit). Si vous obtenez une page de vérification, un 403 ou une coquille vide au lieu du texte produit, une des autres portes est fermée. - Demandez à votre hébergeur ou à votre CDN quel préréglage de gestion des bots est actif, et si les crawlers d'IA figurent dans la liste des blocages.
Rien de tout cela ne nécessite un développeur au-delà de l'étape deux, et le correctif tient en général en une ligne ou un interrupteur. La raison de le faire cette semaine plutôt qu'un jour est simple : un assistant qui ne peut pas lire votre page ne peut pas la comparer, et un produit qu'on ne peut pas comparer n'est pas recommandé.