Pubblicato 7 settembre 2026
Come un sito decide quali crawler AI fa entrare
Prima che un assistente AI possa leggere una pagina, nelle prime centinaia di millisecondi scattano quattro controlli: reputazione dell'IP, header della richiesta, una sfida JavaScript, un rate limit. Basta uno di questi per respingerlo, e il 22,6% dei primi 10.000 siti respinge di proposito almeno un crawler AI. Cosa fa ogni controllo, perché uno shop può essere invisibile senza saperlo e come verificarlo.
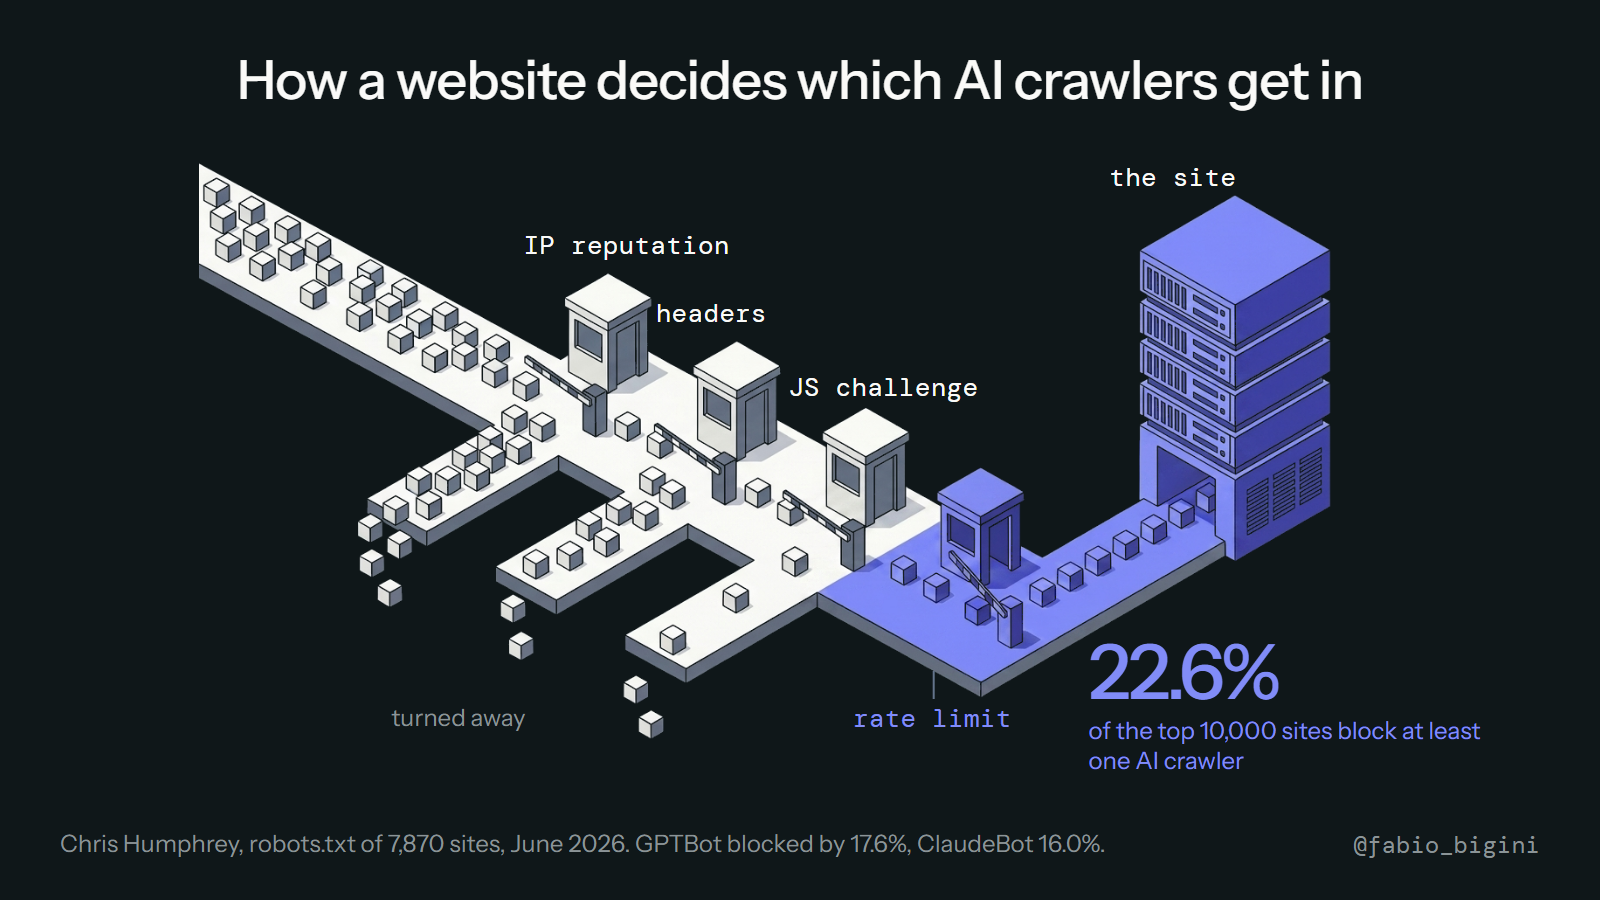
Quando un assistente AI legge la pagina di un tuo prodotto, non apre un browser e la guarda. Invia una richiesta, come qualsiasi crawler, e il tuo stack di hosting decide in poche centinaia di millisecondi se rispondere. La maggior parte dei titolari di shop non ha mai visto questa decisione, e un numero crescente di siti la prende contro i crawler AI senza che nessuno in azienda lo sappia.
Ecco i quattro controlli, nell'ordine in cui una richiesta li incontra, e cosa dicono i numeri.
I quattro cancelli
1. Reputazione dell'IP. Prima che il tuo server veda qualcosa, una CDN o un livello di bot management (Cloudflare, Akamai, DataDome e simili) guarda da dove arriva la richiesta. I range dei crawler noti ricevono un'etichetta. Alcuni vengono ammessi, altri messi alla prova, altri scartati. Questo cancello funziona con le regole del provider di rete, che spesso sono quelle predefinite.
2. Header della richiesta. Ogni crawler si presenta con una stringa user-agent: GPTBot, ClaudeBot, PerplexityBot, Google-Extended. Il tuo file robots.txt, e le eventuali regole basate sugli header, dicono sì o no nome per nome. È l'unico cancello che controlli completamente con un file di testo, ed è quello misurato dallo studio qui sotto.
3. Sfida JavaScript. Se il livello di protezione non è sicuro, serve un piccolo script che il visitatore deve eseguire prima che la pagina vera venga caricata. I browser lo fanno in modo invisibile. La maggior parte dei fetcher AI non esegue JavaScript, quindi la sfida diventa un muro: l'assistente riceve la pagina della sfida, non la pagina del prodotto, e passa oltre.
4. Rate limit. Anche un crawler ammesso che chiede troppe pagine troppo in fretta viene rallentato o interrotto. Per un crawler che legge cinque pagine per rispondere a una domanda questo conta raramente; per un crawler di addestramento che passa al setaccio un intero catalogo conta molto, e gli hosting spesso impostano un unico limite per entrambi.
Basta un solo cancello per dire no. L'assistente non segnala il rifiuto: la risposta viene semplicemente costruita con le pagine che ha potuto leggere.
Cosa dicono i numeri
Chris Humphrey ha controllato il robots.txt dei primi 10.000 siti web (7.870 con un risultato determinabile) a giugno 2026 (fonte):
| Quota dei siti principali che lo bloccano | |
|---|---|
| GPTBot (OpenAI) | 17,6% |
| ClaudeBot (Anthropic) | 16,0% |
| Google-Extended | 14,5% |
| PerplexityBot | 10,4% |
| Almeno un crawler AI | 22,6% |
Questo riguarda solo il secondo cancello. Il primo, il terzo e il quarto non sono visibili dall'esterno e, secondo la nostra esperienza con gli shop, sono più spesso il motivo per cui una pagina risulta illeggibile: una regola bot predefinita sulla CDN, o una sfida JavaScript che nessuno ricorda di aver attivato.
Perché è facile sbagliare
Bloccare i crawler di addestramento è una scelta ragionevole: un editore può non volere che i suoi testi vengano usati per addestrare i modelli. Ma lo stesso blocco spesso colpisce anche il crawler che legge le pagine per rispondere a una domanda in questo momento. OpenAI, per esempio, usa nomi diversi per l'addestramento (GPTBot) e per la ricerca in tempo reale (OAI-SearchBot, ChatGPT-User); una regola scritta contro "GPT" li colpisce tutti e tre. Il risultato è uno shop che ha scelto di restare fuori dall'addestramento e, senza volerlo, fuori dalle raccomandazioni.
Le piattaforme di hosting commettono lo stesso errore al posto tuo. Diversi hosting commerce gestiti arrivano con i crawler AI bloccati per impostazione predefinita al primo o al terzo cancello, e l'opzione sta in un pannello di sicurezza che nessuno apre.
Come verificarlo in cinque minuti
- Apri
iltuoshop.com/robots.txte cercaGPTBot,ClaudeBot,PerplexityBot,OAI-SearchBot. UnDisallow: /sotto uno di questi è il secondo cancello che dice no. - Richiedi una pagina prodotto con lo user-agent di un crawler dall'esterno della tua rete (basta un
curlcon-A "GPTBot"). Se ottieni una pagina di sfida, un 403 o un guscio vuoto invece del testo del prodotto, uno degli altri cancelli è chiuso. - Chiedi al tuo hosting o alla tua CDN quale preset di bot management è attivo e se i crawler AI sono nella lista dei bloccati.
Niente di tutto questo richiede uno sviluppatore, tranne il punto due, e la correzione è di solito una riga o un interruttore. Il motivo per farlo questa settimana invece che un giorno qualsiasi è semplice: un assistente che non riesce a leggere la tua pagina non può confrontarla, e un prodotto che non può essere confrontato non viene raccomandato.