Publicado 7 de septiembre de 2026
Cómo decide una web qué rastreadores de IA pueden entrar
Antes de que un asistente de IA pueda leer una página, se ejecutan cuatro controles en los primeros cientos de milisegundos: reputación de IP, cabeceras de la petición, un reto de JavaScript y un límite de peticiones. Cualquiera de ellos puede rechazarla, y el 22,6 % de las 10.000 webs más visitadas bloquea a propósito al menos un rastreador de IA. Qué hace cada control, por qué una tienda puede ser invisible sin saberlo y cómo comprobarlo.
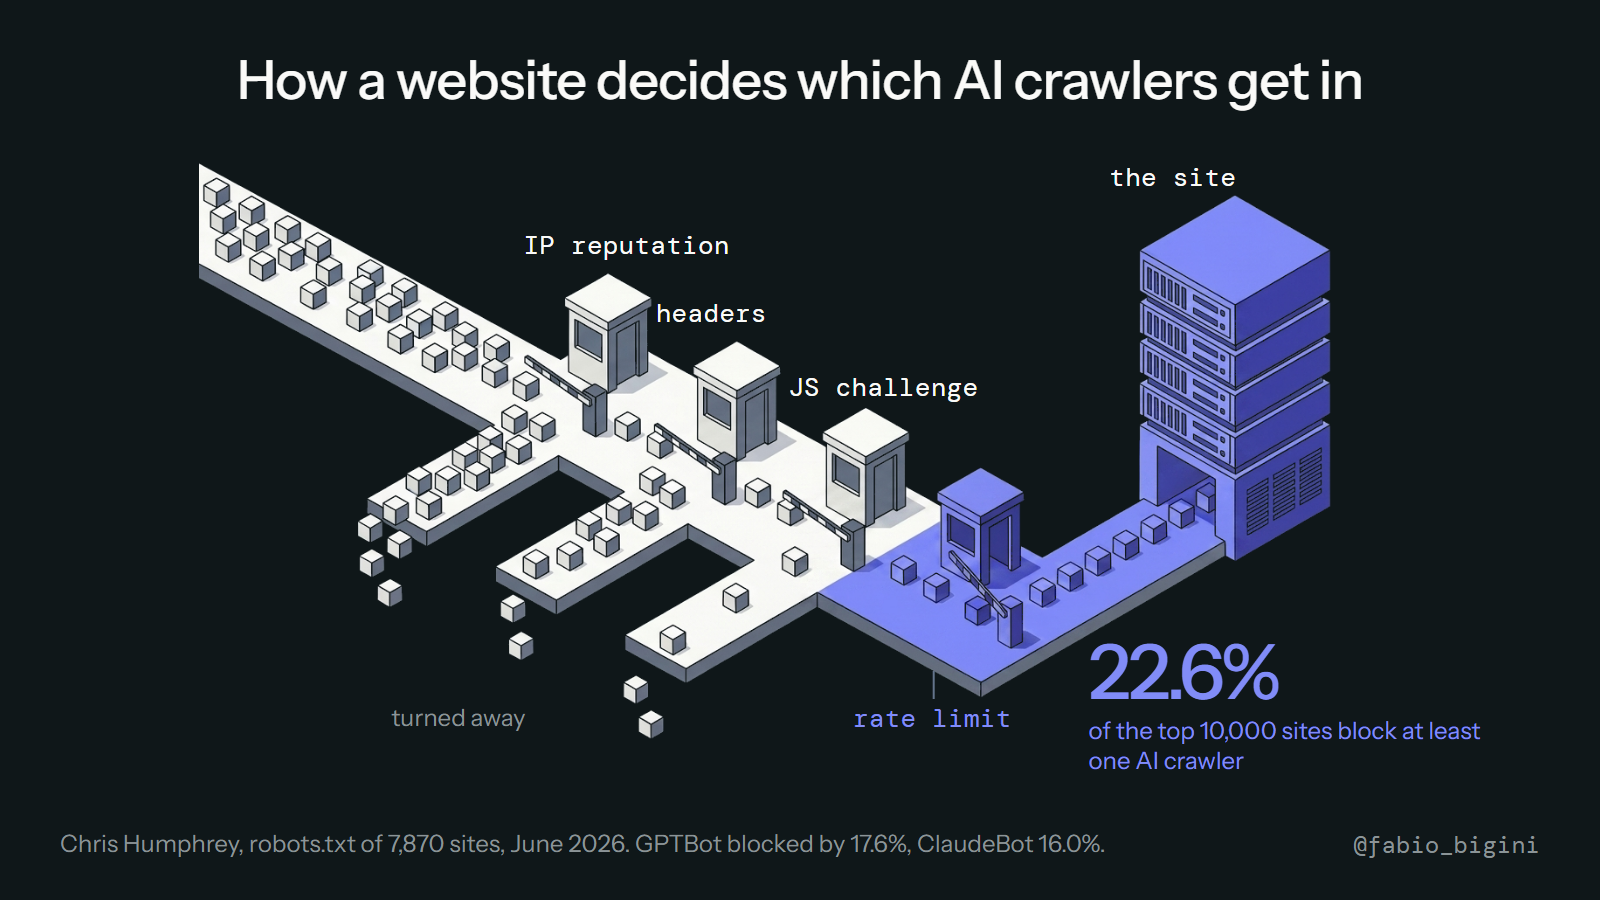
Cuando un asistente de IA lee la página de tu producto, no abre un navegador para mirarla. Envía una petición, como cualquier rastreador, y tu infraestructura de alojamiento decide en unos cientos de milisegundos si responde. Casi ningún propietario de tienda ha visto nunca esa decisión, y cada vez más webs la toman en contra de los rastreadores de IA sin que nadie en la empresa lo sepa.
Estos son los cuatro controles, en el orden en que los encuentra una petición, y lo que dicen los números.
Las cuatro puertas
1. Reputación de IP. Antes de que tu servidor vea nada, una CDN o una capa de gestión de bots (Cloudflare, Akamai, DataDome y similares) mira de dónde viene la petición. Los rangos de rastreadores conocidos reciben una etiqueta. Algunos se permiten, otros se someten a un reto, otros se descartan. Esta puerta funciona con las reglas del proveedor de red, que suelen ser las de fábrica.
2. Cabeceras de la petición. Todo rastreador se presenta con una cadena de user-agent: GPTBot, ClaudeBot, PerplexityBot, Google-Extended. Tu archivo robots.txt, y cualquier regla basada en cabeceras, dice sí o no según el nombre. Es la única puerta que controlas por completo con un archivo de texto, y la que midió el estudio que verás abajo.
3. Reto de JavaScript. Si la capa duda, sirve un pequeño script que el visitante debe ejecutar antes de que cargue la página real. Los navegadores lo hacen de forma invisible. La mayoría de los rastreadores de IA no ejecutan JavaScript, así que el reto es un muro: el asistente recibe la página del reto, no la de tu producto, y sigue adelante.
4. Límite de peticiones. Incluso un rastreador permitido que pide demasiadas páginas demasiado rápido se ve limitado o cortado. Para un rastreador que lee cinco páginas para responder a una pregunta esto rara vez importa; para un rastreador de entrenamiento que barre un catálogo entero, sí, y los proveedores suelen fijar un mismo límite para ambos.
Cualquiera de las puertas puede decir no. El asistente no informa del rechazo: la respuesta simplemente se construye con las páginas que ha podido leer.
Lo que dicen los números
Chris Humphrey revisó el robots.txt de las 10.000 webs más visitadas (7.870 con un resultado determinable) en junio de 2026 (fuente):
| Porcentaje de webs principales que lo bloquean | |
|---|---|
| GPTBot (OpenAI) | 17,6 % |
| ClaudeBot (Anthropic) | 16,0 % |
| Google-Extended | 14,5 % |
| PerplexityBot | 10,4 % |
| Al menos un rastreador de IA | 22,6 % |
Eso es solo la puerta dos. Las puertas uno, tres y cuatro no se ven desde fuera y son, según nuestra experiencia con tiendas, más a menudo el motivo de que una página resulte ilegible: una regla de bots por defecto en la CDN, o un reto de JavaScript que nadie recuerda haber activado.
Por qué es fácil equivocarse
Bloquear los rastreadores de entrenamiento es una decisión razonable: un editor puede no querer que su texto se use para entrenar modelos. Pero ese mismo bloqueo suele atrapar al rastreador que lee páginas para responder a una pregunta en este momento. OpenAI, por ejemplo, usa nombres distintos para el entrenamiento (GPTBot) y para la búsqueda en directo (OAI-SearchBot, ChatGPT-User); una regla escrita contra "GPT" atrapa a los tres. El resultado es una tienda que se excluyó del entrenamiento y, sin pretenderlo, de las recomendaciones.
Las plataformas de alojamiento cometen el mismo error en tu nombre. Varios proveedores de comercio gestionado vienen con los rastreadores de IA bloqueados por defecto en la puerta uno o tres, y el ajuste está en un panel de seguridad que nadie abre.
Cómo comprobarlo en cinco minutos
- Abre
tutienda.com/robots.txty buscaGPTBot,ClaudeBot,PerplexityBot,OAI-SearchBot. UnDisallow: /bajo cualquiera de ellos es la puerta dos diciendo no. - Pide una página de producto con el user-agent de un rastreador desde fuera de tu red (basta un
curlcon-A "GPTBot"). Si recibes una página de reto, un 403 o un armazón vacío en lugar del texto del producto, alguna de las otras puertas está cerrada. - Pregunta a tu proveedor de alojamiento o CDN qué configuración de gestión de bots está activa y si los rastreadores de IA están en la lista de bloqueados.
Nada de esto requiere un desarrollador más allá del paso dos, y el arreglo suele ser una línea o un interruptor. La razón para hacerlo esta semana y no algún día es simple: un asistente que no puede leer tu página no puede compararla, y un producto que no se puede comparar no se recomienda.