Publicado 7 de setembro de 2026
Como um site decide que crawlers de IA podem entrar
Antes de um assistente de IA conseguir ler uma página, correm quatro verificações nas primeiras centenas de milissegundos: reputação do IP, cabeçalhos do pedido, um desafio de JavaScript, um limite de taxa. Qualquer uma delas pode recusar o acesso, e 22,6% dos 10 000 maiores sites bloqueiam deliberadamente pelo menos um crawler de IA. O que faz cada verificação, porque é que uma loja pode estar invisível sem saber, e como descobrir.
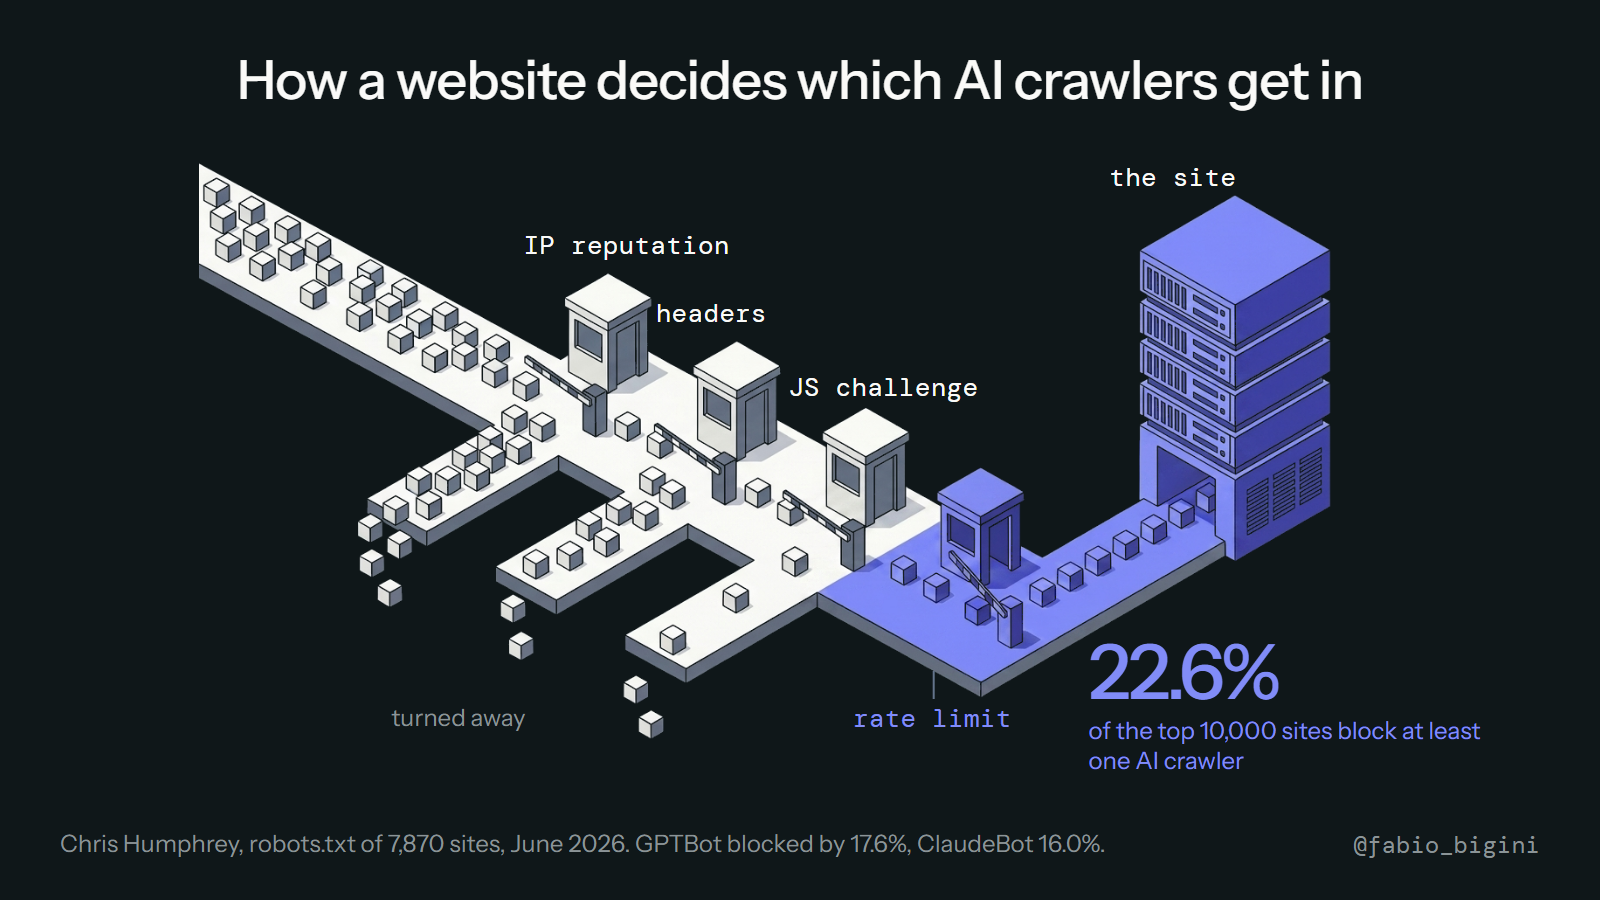
Quando um assistente de IA lê a sua página de produto, não abre um browser para a ver. Envia um pedido, como qualquer crawler, e a sua infraestrutura de alojamento decide em poucas centenas de milissegundos se responde. A maioria dos donos de loja nunca viu essa decisão, e um número crescente de sites toma-a contra os crawlers de IA sem que ninguém no negócio saiba.
Aqui ficam as quatro verificações, pela ordem em que um pedido as encontra, e o que dizem os números.
Os quatro portões
1. Reputação do IP. Antes de o seu servidor ver o que quer que seja, uma CDN ou camada de gestão de bots (Cloudflare, Akamai, DataDome e afins) olha para a origem do pedido. As gamas de IP de crawlers conhecidos recebem uma etiqueta. Alguns são permitidos, outros são desafiados, outros são descartados. Este portão funciona com as regras do fornecedor de rede, que são muitas vezes as predefinições.
2. Cabeçalhos do pedido. Todos os crawlers se apresentam com uma string de user-agent: GPTBot, ClaudeBot, PerplexityBot, Google-Extended. O seu ficheiro robots.txt, e quaisquer regras baseadas em cabeçalhos, dizem sim ou não a cada nome. Este é o único portão que controla por completo com um ficheiro de texto, e o que o estudo abaixo mediu.
3. Desafio de JavaScript. Se a camada estiver insegura, serve um pequeno script que o visitante tem de executar antes de a página real carregar. Os browsers fazem-no de forma invisível. A maioria dos fetchers de IA não executa JavaScript, por isso o desafio é um muro: o assistente recebe a página do desafio, não a sua página de produto, e segue caminho.
4. Limite de taxa. Mesmo um crawler autorizado que peça páginas a mais e depressa a mais acaba travado ou cortado. Para um crawler que lê cinco páginas para responder a uma pergunta isto raramente importa; para um crawler de treino que varre um catálogo inteiro importa, e os alojamentos definem muitas vezes um único limite para ambos.
Qualquer um dos portões pode dizer não. O assistente não reporta a recusa; a resposta é simplesmente construída com as páginas que conseguiu ler.
O que dizem os números
Chris Humphrey analisou o robots.txt dos 10 000 maiores websites (7870 com resultado determinável) em junho de 2026 (fonte):
| Percentagem dos maiores sites que o bloqueiam | |
|---|---|
| GPTBot (OpenAI) | 17,6% |
| ClaudeBot (Anthropic) | 16,0% |
| Google-Extended | 14,5% |
| PerplexityBot | 10,4% |
| Pelo menos um crawler de IA | 22,6% |
Isto é apenas o portão dois. Os portões um, três e quatro não são visíveis do exterior e são, pela nossa experiência com lojas, mais vezes a razão pela qual uma página fica ilegível: uma regra de bots predefinida na CDN, ou um desafio de JavaScript que ninguém se lembra de ter ligado.
Porque é fácil errar nisto
Bloquear crawlers de treino é uma escolha razoável: um editor pode não querer que o seu texto seja usado para treinar modelos. Mas o mesmo bloqueio apanha muitas vezes o crawler que lê páginas para responder a uma pergunta agora mesmo. A OpenAI, por exemplo, usa nomes diferentes para treino (GPTBot) e para pesquisa em tempo real (OAI-SearchBot, ChatGPT-User); uma regra escrita contra "GPT" apanha os três. O resultado é uma loja que optou por sair do treino e, sem querer, saiu também das recomendações.
As plataformas de alojamento cometem o mesmo erro em seu nome. Vários alojamentos de comércio geridos vêm com os crawlers de IA bloqueados por predefinição no portão um ou três, e a definição está num painel de segurança que ninguém abre.
Como descobrir em cinco minutos
- Abra
asualoja.com/robots.txte procureGPTBot,ClaudeBot,PerplexityBot,OAI-SearchBot. UmDisallow: /sob qualquer um deles é o portão dois a dizer não. - Peça uma página de produto com o user-agent de um crawler a partir de fora da sua rede (um
curlcom-A "GPTBot"resolve). Se receber uma página de desafio, um 403, ou uma casca vazia em vez do texto do produto, um dos outros portões está fechado. - Pergunte ao seu alojamento ou CDN qual o preset de gestão de bots ativo, e se os crawlers de IA estão na lista de bloqueados.
Nada disto precisa de um programador para além do passo dois, e a correção é normalmente uma linha ou um botão. A razão para o fazer esta semana em vez de um dia destes é simples: um assistente que não consegue ler a sua página não a consegue comparar, e um produto que não pode ser comparado não é recomendado.