Veröffentlicht 7. September 2026
Wie eine Website entscheidet, welche KI-Crawler hereinkommen
Bevor ein KI-Assistent eine Seite lesen kann, laufen in den ersten Hundertstelsekunden vier Prüfungen: IP-Reputation, Request-Header, eine JavaScript-Challenge, ein Rate Limit. Jede einzelne kann ihn abweisen, und 22,6 % der Top-10.000-Websites weisen mindestens einen KI-Crawler absichtlich ab. Was jede Prüfung macht, warum ein Shop unsichtbar sein kann, ohne es zu wissen, und wie Sie das herausfinden.
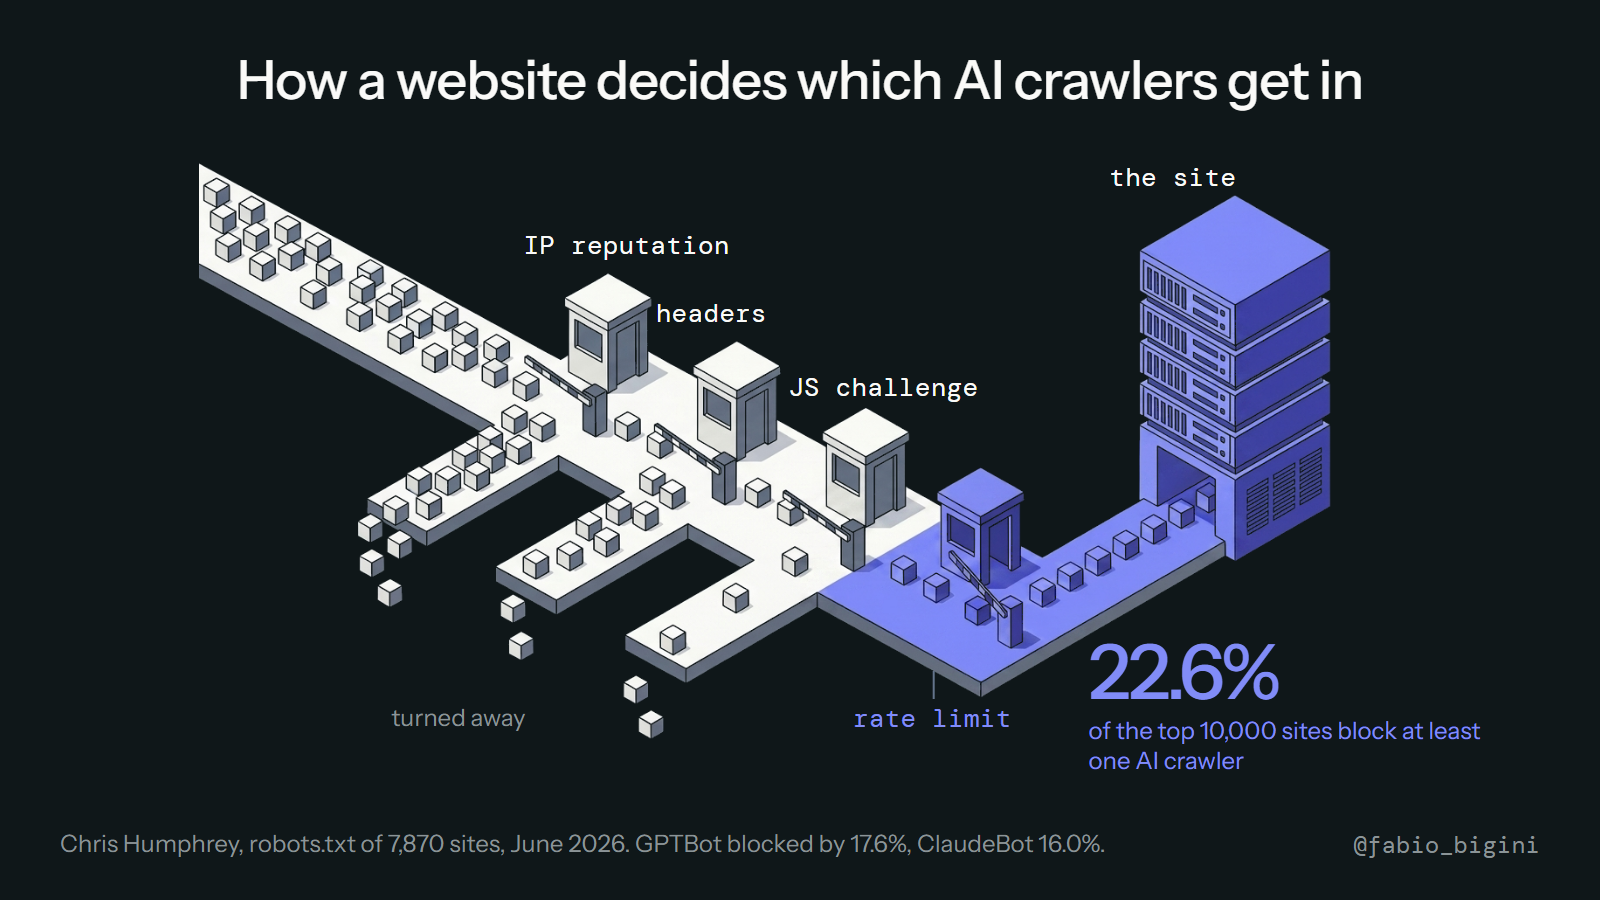
Wenn ein KI-Assistent Ihre Produktseite liest, öffnet er keinen Browser und schaut sie an. Er schickt einen Request, wie jeder Crawler, und Ihr Hosting-Stack entscheidet in ein paar Hundertstelsekunden, ob er antwortet. Die meisten Shop-Betreiber haben diese Entscheidung nie gesehen, und immer mehr Websites fällen sie gegen die KI-Crawler, ohne dass irgendwer im Unternehmen davon weiß.
Hier sind die vier Prüfungen, in der Reihenfolge, in der ein Request auf sie trifft, und was die Zahlen sagen.
Die vier Tore
1. IP-Reputation. Noch bevor Ihr Server etwas sieht, schaut ein CDN oder eine Bot-Management-Schicht (Cloudflare, Akamai, DataDome und ähnliche) darauf, woher der Request kommt. Bekannte Crawler-Bereiche bekommen ein Label. Einige werden zugelassen, einige bekommen eine Challenge, einige werden verworfen. Dieses Tor läuft nach den Regeln des Netzwerkanbieters, und das sind oft die Standardeinstellungen.
2. Request-Header. Jeder Crawler stellt sich mit einem User-Agent-String vor: GPTBot, ClaudeBot, PerplexityBot, Google-Extended. Ihre robots.txt und alle header-basierten Regeln sagen pro Name ja oder nein. Das ist das einzige Tor, das Sie vollständig über eine Textdatei steuern, und das, was die Studie unten gemessen hat.
3. JavaScript-Challenge. Ist die Schicht unsicher, liefert sie ein kleines Skript aus, das der Besucher ausführen muss, bevor die eigentliche Seite lädt. Browser machen das unsichtbar. Die meisten KI-Fetcher führen kein JavaScript aus, also ist die Challenge eine Wand: Der Assistent bekommt die Challenge-Seite, nicht Ihre Produktseite, und zieht weiter.
4. Rate Limit. Selbst ein zugelassener Crawler, der zu viele Seiten zu schnell abfragt, wird gebremst oder abgeschnitten. Für einen Crawler, der fünf Seiten liest, um eine Frage zu beantworten, spielt das selten eine Rolle; für einen Training-Crawler, der einen ganzen Katalog durchgeht, schon, und Hoster setzen oft ein Limit für beide.
Jedes einzelne Tor kann nein sagen. Der Assistent meldet keine Abweisung; die Antwort wird einfach aus den Seiten gebaut, die er lesen konnte.
Was die Zahlen sagen
Chris Humphrey hat im Juni 2026 die robots.txt der Top-10.000-Websites geprüft (7.870 mit einem bestimmbaren Ergebnis) (Quelle):
| Anteil der Top-Websites, die ihn blockieren | |
|---|---|
| GPTBot (OpenAI) | 17,6 % |
| ClaudeBot (Anthropic) | 16,0 % |
| Google-Extended | 14,5 % |
| PerplexityBot | 10,4 % |
| Mindestens ein KI-Crawler | 22,6 % |
Das ist nur Tor zwei. Die Tore eins, drei und vier sind von außen nicht sichtbar und sind nach unserer Erfahrung mit Shops häufiger der Grund, warum eine Seite nicht lesbar ist: eine Standard-Bot-Regel im CDN oder eine JavaScript-Challenge, an deren Aktivierung sich niemand erinnert.
Warum man das leicht falsch macht
Training-Crawler zu blockieren ist eine vernünftige Entscheidung: Ein Verlag will vielleicht nicht, dass seine Texte zum Trainieren von Modellen verwendet werden. Aber dieselbe Sperre erwischt oft auch den Crawler, der Seiten liest, um jetzt gerade eine Frage zu beantworten. OpenAI zum Beispiel nutzt unterschiedliche Namen für Training (GPTBot) und für die Live-Suche (OAI-SearchBot, ChatGPT-User); eine Regel gegen "GPT" erwischt alle drei. Das Ergebnis ist ein Shop, der sich gegen Training entschieden hat und, ohne es zu wollen, gegen Empfehlungen.
Hosting-Plattformen machen denselben Fehler in Ihrem Namen. Mehrere Managed-Commerce-Hoster kommen standardmäßig mit KI-Crawlern, die an Tor eins oder drei blockiert sind, und die Einstellung liegt in einem Sicherheits-Panel, das niemand öffnet.
So finden Sie es in fünf Minuten heraus
- Öffnen Sie
ihrshop.de/robots.txtund suchen Sie nachGPTBot,ClaudeBot,PerplexityBot,OAI-SearchBot. EinDisallow: /unter einem davon ist Tor zwei, das nein sagt. - Rufen Sie eine Produktseite mit dem User-Agent eines Crawlers von außerhalb Ihres Netzwerks ab (ein
curlmit-A "GPTBot"genügt). Bekommen Sie eine Challenge-Seite, einen 403 oder eine leere Hülle statt des Produkttexts, ist eines der anderen Tore geschlossen. - Fragen Sie Ihren Hoster oder CDN, welches Bot-Management-Preset aktiv ist und ob KI-Crawler auf der Blockliste stehen.
Nichts davon braucht einen Entwickler, außer Schritt zwei, und die Korrektur ist meist eine Zeile oder ein Schalter. Der Grund, es diese Woche zu tun und nicht irgendwann, ist einfach: Ein Assistent, der Ihre Seite nicht lesen kann, kann sie nicht vergleichen, und ein Produkt, das nicht verglichen werden kann, wird nicht empfohlen.