Gepubliceerd 7 september 2026
Hoe een website bepaalt welke AI-crawlers binnenkomen
Voordat een AI-assistent een pagina kan lezen, draaien er in de eerste paar honderd milliseconden vier controles: IP-reputatie, request-headers, een JavaScript-challenge, een rate limit. Elk ervan kan hem tegenhouden, en 22,6% van de top-10.000 sites houdt bewust minstens één AI-crawler tegen. Wat elke controle doet, waarom een webshop onzichtbaar kan zijn zonder het te weten, en hoe je het uitzoekt.
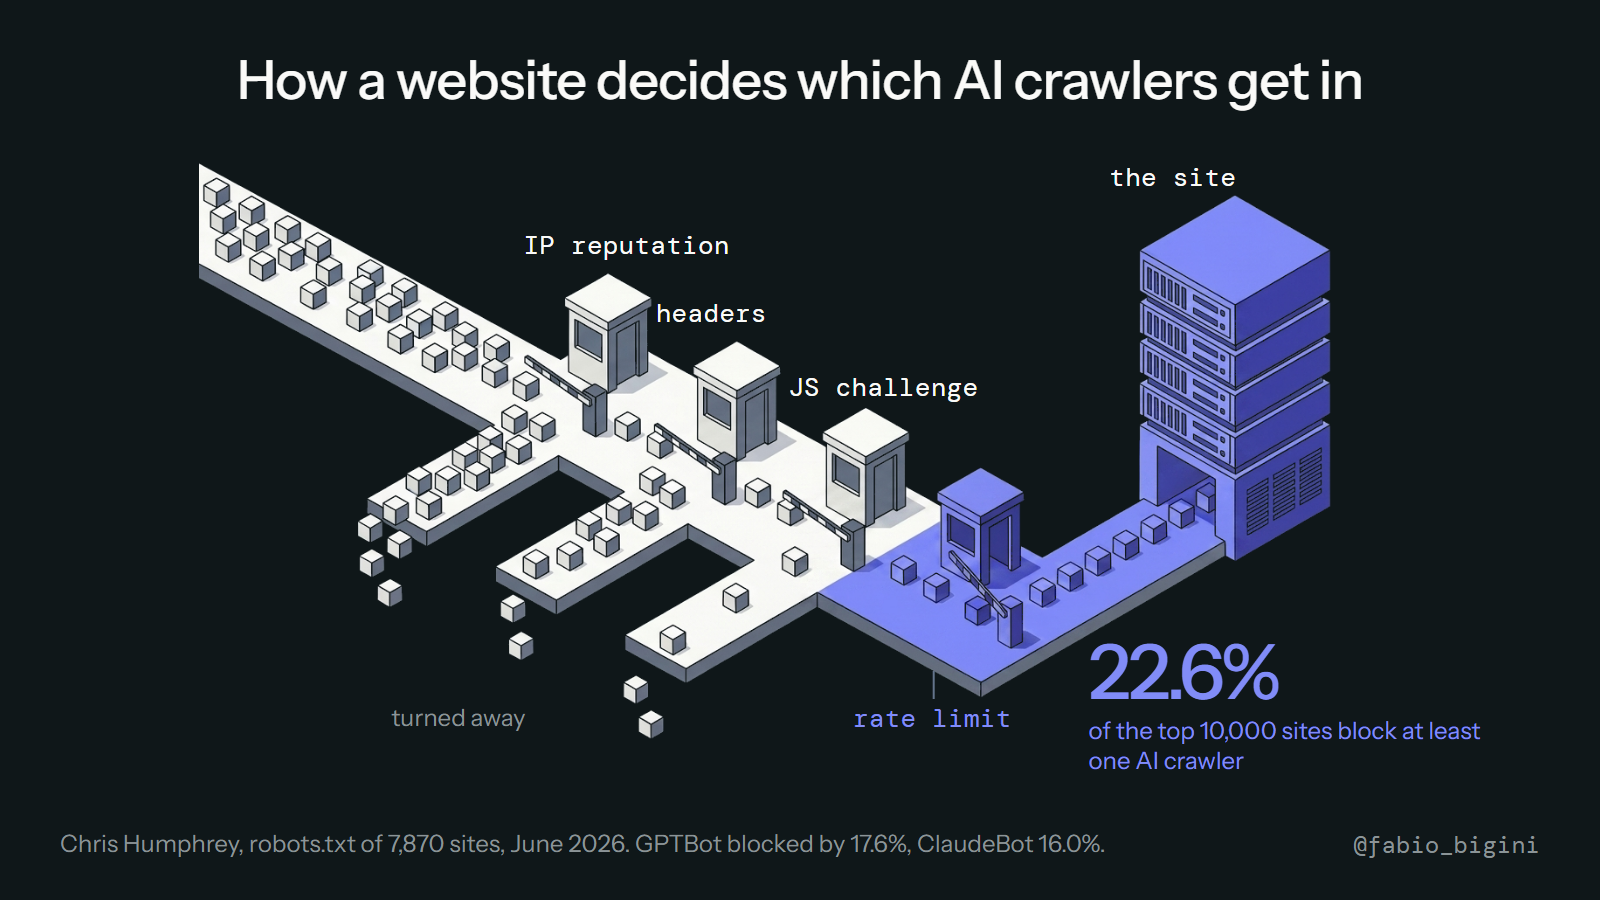
Als een AI-assistent jouw productpagina leest, opent hij geen browser om ernaar te kijken. Hij stuurt een verzoek, net als elke crawler, en jouw hostingstack beslist in een paar honderd milliseconden of hij antwoord krijgt. De meeste webshopeigenaren hebben die beslissing nooit gezien, en een groeiend aantal sites neemt hem tegen AI-crawlers zonder dat iemand in het bedrijf het weet.
Dit zijn de vier controles, in de volgorde waarin een verzoek ze tegenkomt, en wat de cijfers zeggen.
De vier poorten
1. IP-reputatie. Voordat je server iets ziet, kijkt een CDN of bot-managementlaag (Cloudflare, Akamai, DataDome en dergelijke) waar het verzoek vandaan komt. Bekende crawler-ranges krijgen een label. Sommige mogen door, sommige krijgen een challenge, sommige worden weggegooid. Deze poort draait op de regels van de netwerkprovider, en dat zijn vaak de standaardinstellingen.
2. Request-headers. Elke crawler stelt zich voor met een user-agent: GPTBot, ClaudeBot, PerplexityBot, Google-Extended. Jouw robots.txt en eventuele header-regels zeggen per naam ja of nee. Dit is de enige poort die je volledig beheert met een tekstbestand, en de poort die het onderzoek hieronder heeft gemeten.
3. JavaScript-challenge. Twijfelt de laag, dan serveert hij een klein script dat de bezoeker moet uitvoeren voordat de echte pagina laadt. Browsers doen dat onzichtbaar. De meeste AI-fetchers voeren geen JavaScript uit, dus de challenge is een muur: de assistent krijgt de challenge-pagina, niet je productpagina, en gaat verder.
4. Rate limit. Zelfs een toegelaten crawler die te veel pagina's te snel opvraagt, wordt afgeremd of afgesloten. Voor een crawler die vijf pagina's leest om één vraag te beantwoorden maakt dat zelden uit; voor een trainingscrawler die een hele catalogus doorloopt wel, en hosts zetten vaak één limiet voor allebei.
Elke poort kan nee zeggen. De assistent meldt geen weigering; het antwoord wordt gewoon gebouwd uit de pagina's die hij wél kon lezen.
Wat de cijfers zeggen
Chris Humphrey controleerde in juni 2026 de robots.txt van de top-10.000 websites (7.870 met een bruikbaar resultaat) (bron):
| Aandeel topsites dat hem blokkeert | |
|---|---|
| GPTBot (OpenAI) | 17,6% |
| ClaudeBot (Anthropic) | 16,0% |
| Google-Extended | 14,5% |
| PerplexityBot | 10,4% |
| Minstens één AI-crawler | 22,6% |
Dat is alleen poort twee. Poorten één, drie en vier zijn van buitenaf niet zichtbaar en zijn, in onze ervaring met webshops, vaker de reden dat een pagina onleesbaar is: een standaard botregel bij het CDN, of een JavaScript-challenge waarvan niemand meer weet dat hij aanstaat.
Waarom dit makkelijk misgaat
Trainingscrawlers blokkeren is een redelijke keuze: een uitgever wil zijn tekst misschien niet gebruikt zien om modellen te trainen. Maar dezelfde blokkade vangt vaak ook de crawler die pagina's leest om nú een vraag te beantwoorden. OpenAI gebruikt bijvoorbeeld verschillende namen voor training (GPTBot) en voor live zoeken (OAI-SearchBot, ChatGPT-User); een regel op "GPT" vangt alle drie. Het resultaat is een webshop die zich afmeldde voor training en, zonder het te willen, ook voor aanbevelingen.
Hostingplatforms maken dezelfde fout namens jou. Verschillende managed-commerce-hosts leveren standaard met AI-crawlers geblokkeerd bij poort één of drie, en de instelling zit in een beveiligingspaneel dat niemand opent.
Hoe je het in vijf minuten uitzoekt
- Open
jouwshop.nl/robots.txten zoek opGPTBot,ClaudeBot,PerplexityBot,OAI-SearchBot. EenDisallow: /onder een van die namen is poort twee die nee zegt. - Haal een productpagina op met de user-agent van een crawler, van buiten je eigen netwerk (een
curlmet-A "GPTBot"volstaat). Krijg je een challenge-pagina, een 403 of een lege huls in plaats van de producttekst, dan is een van de andere poorten dicht. - Vraag je host of CDN welke bot-managementpreset actief is, en of AI-crawlers in de geblokkeerde lijst staan.
Hier komt geen ontwikkelaar aan te pas, behalve bij stap twee, en de fix is meestal één regel of één schakelaar. De reden om het deze week te doen en niet ooit is simpel: een assistent die je pagina niet kan lezen, kan hem niet vergelijken, en een product dat niet vergeleken kan worden, wordt niet aanbevolen.