Gepubliceerd 9 september 2026
Vraag het in het Frans en 16% van wat de AI citeert is Frans. Vraag het in het Engels: 1,4%
Weglot legde dezelfde 400 vragen voor aan vier AI-systemen in vijf landen, één keer in het Engels en één keer in de lokale taal, verspreid over meer dan 16.000 antwoorden. De taal van de vraag veranderde welke pagina's werden geciteerd met meer dan een factor tien. Wat dat betekent voor een site die in één taal bestaat, welke pagina's je eerst vertaalt, en wat het onderzoek niet zegt.
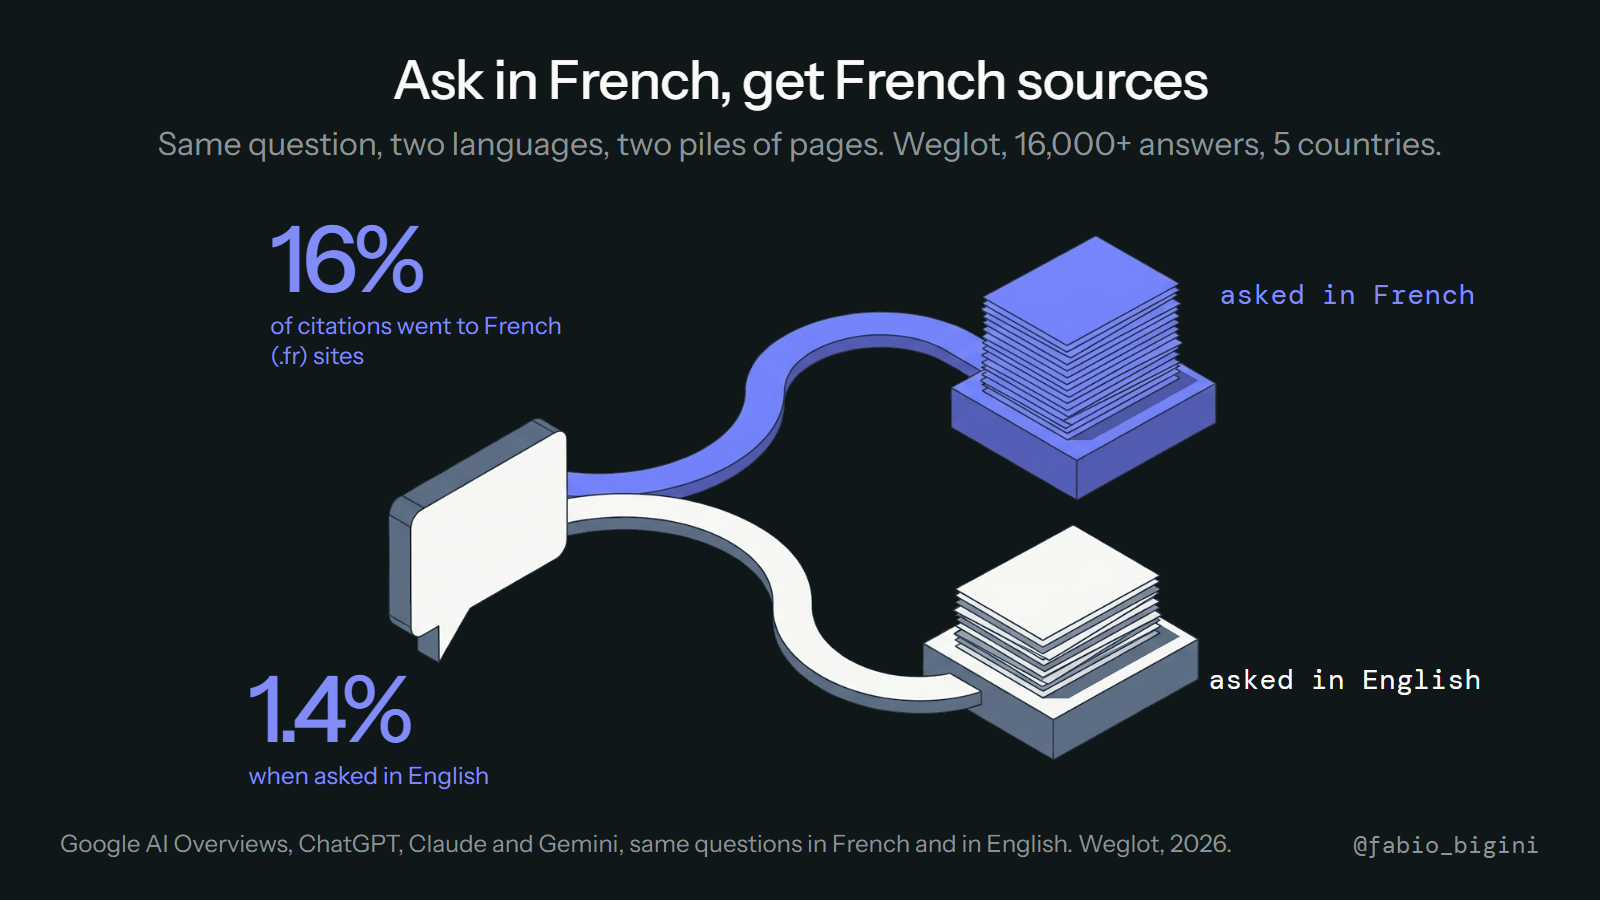
Weglot legde dezelfde 400 vragen voor aan vier AI-systemen in vijf landen, één keer in het Engels en één keer in de lokale taal, en telde waar de citaties naartoe gingen. In Frankrijk stuurden Franstalige vragen 16% van de citaties naar .fr-domeinen. Dezelfde vragen in het Engels: 1,4%. (Weglot, How AI Search Engines Cite Sources by Language and Country)
Meer dan een factor tien verschil, veroorzaakt door niets anders dan de taal waarin de vraag is getypt.
Hetzelfde patroon in elke geteste markt
| Markt | Gevraagd in de lokale taal | Gevraagd in het Engels |
|---|---|---|
| Frankrijk, .fr-domeinen | 16% | 1,4% |
| Japan, .jp-domeinen | 26% | ongeveer 1% |
| Spanje, .es-domeinen | 7% | 1,7% |
Spanje is het cijfer dat je twee keer moet lezen. Slechts 7% van de citaties ging naar .es-domeinen, maar 26% ging naar Spaanstalige bronnen, omdat veel Spaanstalige content op .com-adressen staat. De domeinextensie is een grove indicatie; de taal van de pagina is de echte variabele.
De methode achter deze cijfers: 400 vragen over vijf themacategorieën en drie niveaus van specificiteit, voorgelegd aan GPT 5.5, Claude Haiku 4.5, Gemini Flash 3.5 en Google AI Overviews, in Frankrijk, Spanje, Argentinië, Japan en de Verenigde Staten, elke markt één keer bevraagd in het Engels en één keer in de eigen taal. In totaal meer dan 16.000 antwoorden.
Waarom de taal van de vraag de leeslijst verandert
Een AI-antwoord op een vraag die het niet uit zijn geheugen kan beantwoorden wordt samengesteld, niet opgehaald. Het systeem schrijft een of meer zoekopdrachten, krijgt resultaten, opent er een paar en schrijft op basis van wat het gelezen heeft. Elke stap in die keten erft de taal van de oorspronkelijke vraag.
De zoekopdrachten die het bedenkt zijn in de taal waarin je vroeg. De zoekmachine geeft resultaten terug die bij die taal passen en, meestal, bij het land dat erbij hoort. De pagina's die het daarna opent zijn dus vooral pagina's in die taal. Op het moment dat het model een antwoord formuleert, is de leeslijst al twee keer op taal gefilterd, en je Engelse pagina is nooit als kandidaat langsgekomen.
Daarom is het effect zo groot. Het is niet dat het model Franse bronnen prefereert als je het in het Frans aanspreekt. Het is dat het nooit iets anders heeft opgehaald.
Als je site in één taal bestaat
De ongemakkelijke versie van deze bevinding: een bedrijf met een site die alleen in het Engels bestaat is bijna onzichtbaar voor een koper die in het Frans, Duits of Nederlands vraagt, hoe goed die Engelse pagina ook is. De pagina doet niet mee en verliest. De pagina zit niet in de vijver.
Het omgekeerde geldt net zo goed en wordt makkelijker gemist. Een merk kan sterk zijn in één taal en afwezig in een andere, en niets in de eigen analytics zal dat vertellen. Traffic uit de Engelstalige markt ziet er gezond uit. De Duitse koper die in het Duits vroeg kreeg een shortlist van Duitse leveranciers en is nooit langsgekomen, dus er is geen bezoek om te tellen en geen bounce om te onderzoeken. Afwezigheid laat geen spoor achter.
Wat je eraan doet
Vertaal eerst de pagina's die aankoopvragen beantwoorden. Niet de over-onspagina, niet de blog. De pagina's die vertellen wat een product of dienst is, wat het kost, wat erbij zit, hoe lang het duurt en waarheen je verzendt. Dat zijn de pagina's die een AI opent als het een feit wil bevestigen voordat het je noemt, en dat zijn de pagina's waar de vraag van een koper op landt.
Een machinevertaling van de feiten is beter dan geen pagina. De reflex is wachten tot er budget is voor een echte localisatie. In de tussentijd bestaat de pagina niet in die taal, en dat is de slechtste van de beschikbare situaties. Een correct vertaalde specificatie, prijs en levertijd op een echte URL is vandaag vindbaar; verfijn het later.
Geef elke taal zijn eigen URL, en declareer die. Eén URL per taal, hreflang ertussen, de taal gedeclareerd in de pagina zelf. Een vertaling die pas verschijnt na een taalwissel in de browser, op dezelfde URL, is een vertaling die de crawler en het model misschien nooit zien.
Controleer de markt waarin je denkt te zitten. Stel drie aankoopvragen in elke taal waarin je verkoopt en lees wie er genoemd wordt. Dat is een test van twintig minuten en die beslecht de discussie over de vraag of vertalen de moeite waard is meestal meteen.
Wat dit onderzoek niet zegt
Het is een citatieonderzoek, geen trafficonderzoek. Het telt welke pagina's een AI citeerde, niet hoeveel mensen klikten, en niet hoeveel omzet erop volgde. Een citatie is bewijs dat je in de leeslijst stond, wat de noodzakelijke eerste stap is, niet het bewijs van een verkoop.
Het meet ook pagina's, niet merken. Een antwoord voor een Franse koper met 16% .fr-domeinen in de citaties zegt niets over de vraag of jouw bedrijf in de tekst van dat antwoord genoemd werd, alleen uit welke sites het antwoord is opgebouwd. Die twee dingen hangen samen, maar zijn niet hetzelfde, en het tweede is wat wij per bedrijf meten.
Vijf landen, vier AI-systemen, één meetmoment. De richting is in elke geteste markt consistent genoeg om ernaar te handelen, en de exacte percentages zullen bewegen.
De vraag op het kaartje is nog steeds de juiste eerste vraag: in welke taal vragen je klanten, en bestaat er een pagina in die taal?