Gepubliceerd 9 september 2026
Perplexity citeert 19 pagina's per antwoord. Claude minder dan 4
Orbit Media legde 13.184 citaties vast in 1.765 antwoorden van ChatGPT, Claude, Gemini en Perplexity. De vier tools lezen enorm verschillende hoeveelheden, hebben voorkeur voor andere soorten bronnen en zijn het onderling maar in 1,7% van de gevallen eens. Wat dat betekent als je wilt dat jouw pagina's gelezen worden.
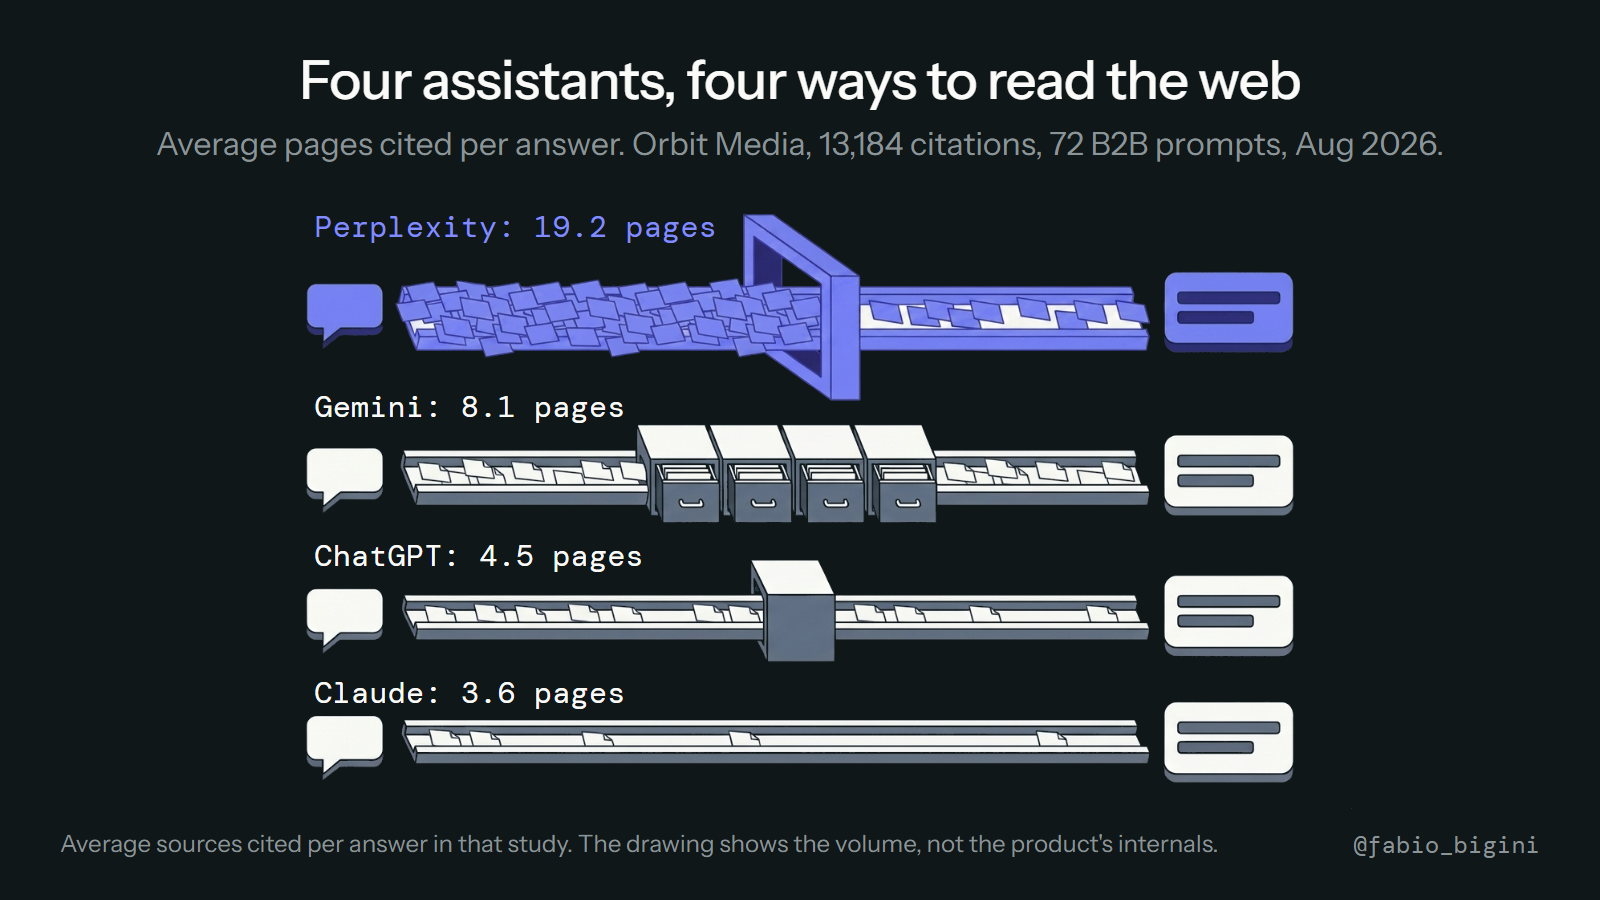
Andy Crestodina van Orbit Media stuurt steeds dezelfde set prompts door vier AI-tools en registreert elke bron die ze citeren. Op 23 augustus 2026 stond de teller op "13.184 citaties en 1.765 antwoorden", uit 72 prompts verdeeld over drie B2B-merken. (Orbit Media, LLM Citation Study)
Het eerste dat de data laten zien: hoe verschillend deze tools lezen. Gemiddeld aantal geciteerde bronnen per antwoord: Perplexity 19,2, Gemini 8,1, ChatGPT 4,5, Claude 3,6. Bij dezelfde vraag raadpleegt de ene tool vijf keer zoveel pagina's als de andere.
Leesbreedte is geen detail
Het is verleidelijk om dit af te doen als een weetje over productontwerp. Dat is het niet, want het aantal pagina's dat een tool opent bepaalt mede je kans om erbij te zitten.
Citeert een assistent vier bronnen voor een vraag in jouw categorie, dan zijn er vier plekken en die gaan naar de meest overduidelijk gezaghebbende pagina's die hij vond. Citeert een andere er negentien, dan is de staart lang genoeg dat een kleinere, specifiekere pagina er nog tussen komt. Dezelfde site kan onzichtbaar zijn in de ene tool en zichtbaar in de andere, puur door het aantal deuren dat openstaat.
Dat verklaart ook een veelvoorkomende en verwarrende ervaring: een bedrijf checkt ChatGPT, komt er niet in voor, checkt Perplexity, komt er wel in voor, en concludeert dat de tools het oneens zijn over de kwaliteit. Dat zijn ze niet. Eén van de twee las simpelweg verder door de lijst.
Ze lezen ook ander soort materiaal
De uitsplitsing naar brontype in het onderzoek is het punt waarop het bruikbaar wordt om te bepalen wat je echt moet doen.
Perplexity leunt op LinkedIn, YouTube en Reddit, met respectievelijk 374, 248 en 232 citaties in de dataset. Gemini leunt op Reddit en listicle-overzichten. ChatGPT neigt naar primaire bronnen: officiële documentatie, arXiv-papers, prijs- en helppagina's van leveranciers zelf. Claude heeft voorkeur voor reviewsites en samengestelde listicles, met reviewplatform Clutch als meest geciteerde externe domein.
Er is één opvallende afwezige. In honderden antwoorden citeerde Claude Reddit geen enkele keer. Voor deze B2B-vragen was Reddit goed voor 0% van Claude's citaties, 0% van die van ChatGPT, 3% bij Perplexity en 1% bij Gemini. Communitydiscussie, dominant in citatieaantallen bij consumentencategorieën, speelt hier nauwelijks een rol.
De praktische conclusie: het advies "zorg dat er op Reddit over je gepraat wordt" is categoriespecifiek advies, geen wet. Voor een B2B-dienst zijn een plek in een geloofwaardig overzichtsartikel, documentatie die een model kan citeren en een vermelding op een reviewplatform elk dichter bij het mechanisme van minstens één grote tool.
De vier tools overlappen nauwelijks
De bevinding die al het andere in perspectief zet: bij dezelfde vragen citeerden de vier modellen slechts in 1,7% van de gevallen hetzelfde domein.
Dat betekent dat er geen enkele lijst bestaat met "de pagina's die AI citeert". Er zijn vier grotendeels gescheiden leeslijsten, opgebouwd door vier verschillende retrievalsystemen met vier verschillende voorkeuren, en een pagina die aan de ene voldoet kan voor de andere structureel onzichtbaar zijn. Optimaliseren voor één tool en aannemen dat de rest volgt, is een fout die de data niet ondersteunen.
Het betekent ook dat een zichtbaarheidscheck bij één assistent je iets vertelt over die ene assistent. Als jouw kopers ChatGPT gebruiken en jij Perplexity hebt gemeten, heb je de markt van iemand anders gemeten.
Wat je hiermee doet
Er volgen drie dingen uit, op volgorde van inspanning.
Zoek uit welke tool je kopers echt gebruiken en meet die eerst. In zakelijke categorieën is dat nog steeds meestal ChatGPT, tegelijk de smalste lezer van de vier, dus de moeilijkste en waardevolste plek om vast te houden.
Geef de lezers van primaire bronnen iets om te citeren. ChatGPT's voorkeur voor documentatie, prijspagina's en helpcontent is een voorkeur voor pagina's die feiten helder benoemen en actueel houden. Een specificatiepagina met echte getallen in tekst wint van een brochurepagina over excellentie, precies omdat een model de een wel kan citeren en de ander niet.
Wees aanwezig waar de brede lezers kijken. Bij tools die vijftien of twintig pagina's raadplegen, is aanwezigheid in de overzichtsartikelen, vergelijkingspagina's en reviewplatforms van je categorie het verschil tussen meeliften in de staart en helemaal ontbreken. Dat zijn ook de pagina's die je niet zelf kunt schrijven, en daarom duurt dit langer dan je eigen site op orde brengen.
De beperkingen
Tweeënzeventig prompts over drie B2B-merken is een smalle steekproef, en de auteur zegt dat er zelf bij; het is een doorlopend onderzoek, geen telling. De specifieke domeinaantallen zullen schuiven zodra de tools hun retrieval aanpassen. Wat voorlopig niet zal schuiven, is het patroon: deze systemen lezen verschillende hoeveelheden, hebben voorkeur voor andere soorten bronnen en zijn het zelden met elkaar eens.
De vraag was welke van de vier jij het meest gebruikt. Nuttiger is welke jouw klanten gebruiken, en of je die tool ooit specifiek hebt gecheckt.